
第 11 章 RAG 检索增强生成
本章课程目标:
- 把 原书第 2 章 RAG-搭建企业私有/个人知识库 里建立的 RAG 与知识库直觉,继续推进到 LangChain 代码实现层。
- 掌握 LangChain 中构建 RAG 最常见的几类组件:文档加载器、文本分割器、嵌入模型、向量数据库、检索器、提示词模板与聊天模型。
- 跑通并理解本章全部案例:多种文档加载、文本切分、Redis 向量检索、完整 RAG 智能运维助手,把 第 10 章 向量数据库与 Embedding 实战 的内容真正串成一个可落地的问答系统。
学习建议: RAG 最好分成两段看:离线把文档处理成可检索知识,在线根据用户问题召回并组装上下文。读本章时可以用两种颜色标出来:哪些代码属于“建库”,哪些代码属于“问答”。文档加载、切分、Embedding、向量库、Prompt 这些组件的位置清楚了,换任何框架都能读懂。
官方文档与资源:详见 工具导航与参考资料索引 - RAG与向量检索。
1、RAG 简介
1.1 定义
如果你已经读过 原书第 2 章,那么这里可以不再从“知识库产品怎么用”重新讲起,而是直接把 RAG 放回代码语境里理解。
RAG(Retrieval-Augmented Generation,检索增强生成),本质上是一种“先检索,再生成”的应用架构。用户提问后,系统不会立刻只靠大模型自身记忆回答,而是先从外部知识库中检索相关材料,再把这些材料与问题一起交给大模型生成答案。
到了工程实现层,本章更关心的是下面这些问题:
- 外部知识在代码里以什么对象表示
- 文档为什么要先加载、再切块、再向量化
- 向量库和检索器分别负责哪一步
- 检索结果最终怎么进入 Prompt 或消息上下文
所以可以把本章看作:把原书第 2 章里的知识库问答体验,翻译成 LangChain 里的数据结构与组件流水线。
1.2 RAG 的作用
这一点在 原书第 2 章 里已经从产品角度讲过:
RAG 主要是在解决 知识冻结、私有知识缺失、最新信息不可用、回答缺少依据 这类问题。
本章不再重复展开,而是把重点前移到一个更适合开发者的问题上:既然已经知道要用 RAG,那么代码里到底是哪些环节决定了回答质量?
从工程视角看,影响效果最明显的通常不是“有没有接上向量库”这么简单,而是:
- 文档是否被正确加载
- 文本是否被合理切块
- Embedding 是否稳定
- 检索是否召回了真正相关的片段
- Prompt 是否把上下文用对了
和其他方案的关系,仍然可以用下面这张表快速回顾:
| 方案 | 本质 | 优势 | 局限 |
|---|---|---|---|
| 直接问模型 | 不接外部知识,直接生成 | 上手最快 | 容易不知道私有 / 最新知识,幻觉较多 |
| RAG | 先检索资料,再生成 | 更新快、改动小、可追溯 | 依赖文档质量、分块策略、检索效果 |
| 微调 | 调整模型参数 | 能改变回答风格、任务习惯 | 成本高、更新慢,不适合高频改知识 |
| RAG + 微调 | 外部知识 + 参数适配 | 兼顾知识与表达 | 成本和系统复杂度更高 |
同时也要知道,RAG 不是没有代价的万能方案。在真实项目里,它通常会带来几个现实权衡:
- 响应时延更高:每次问答前都要多做一次检索,有时还会经过过滤、重排等步骤。
- Token 消耗更高:检索结果会进入 Prompt,召回内容越多,送给模型的上下文越长。
- 效果依赖链路质量:文档质量、切块策略、Embedding 质量、检索效果、Prompt 约束方式,都会影响最终回答。
1.3 RAG 的标准流程
在 原书第 2 章 里,我们已经从产品与平台角度看过两阶段流程;这里换到 LangChain 代码视角,再把它重述一遍。
LangChain 官方文档通常也把 RAG 拆成两大阶段:索引(Indexing)、检索与生成(Retrieval and Generation)。
这不是为了重复,而是为了把“平台里的按钮和配置项”翻译成“代码里的组件与数据流”。
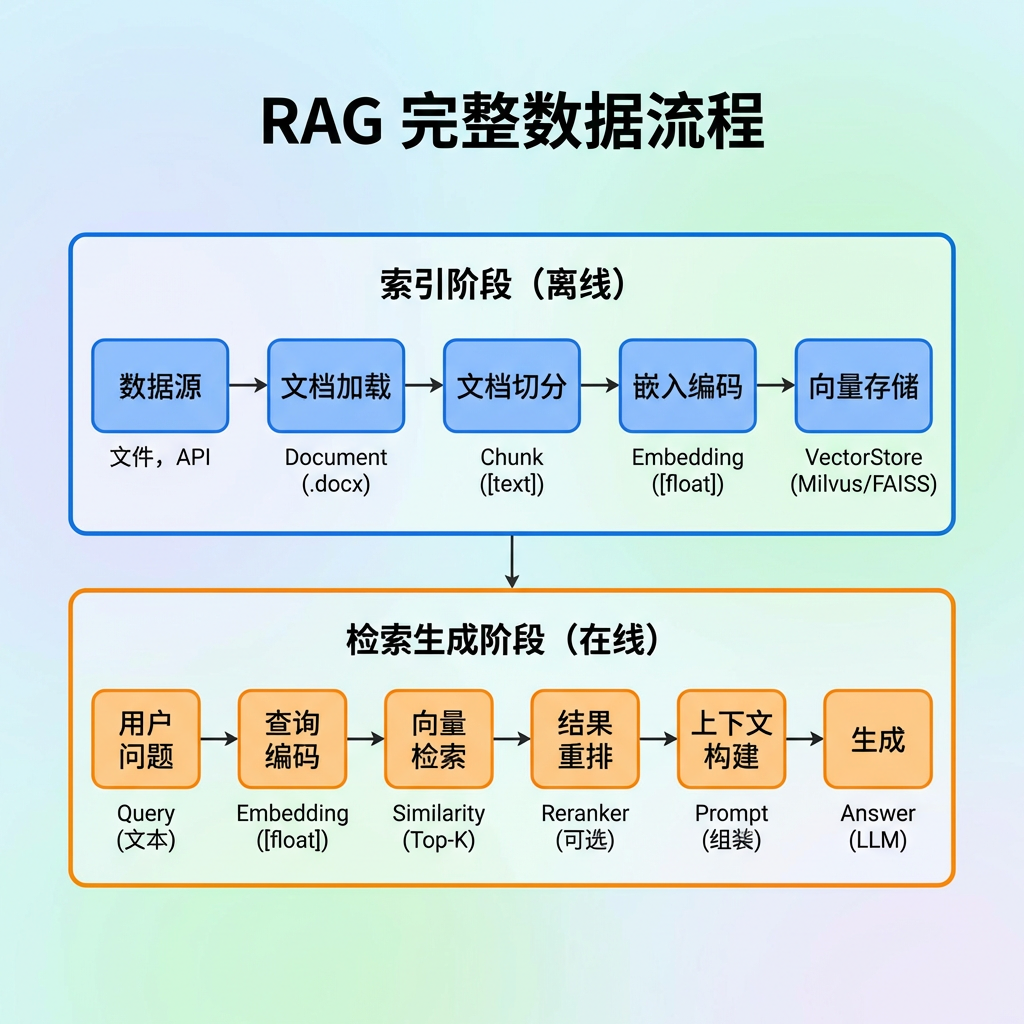
1.3.1 索引阶段:先把知识库准备好
索引阶段面对的是“原始文档”,例如 Word、PDF、Markdown、TXT、CSV、JSON 等文件。它的目标不是回答问题,而是把这些文档处理成“未来方便检索”的形态。
你在原书第 2 章里看到的“上传文件、分段、建知识库”,放到代码里,基本就是这一阶段。
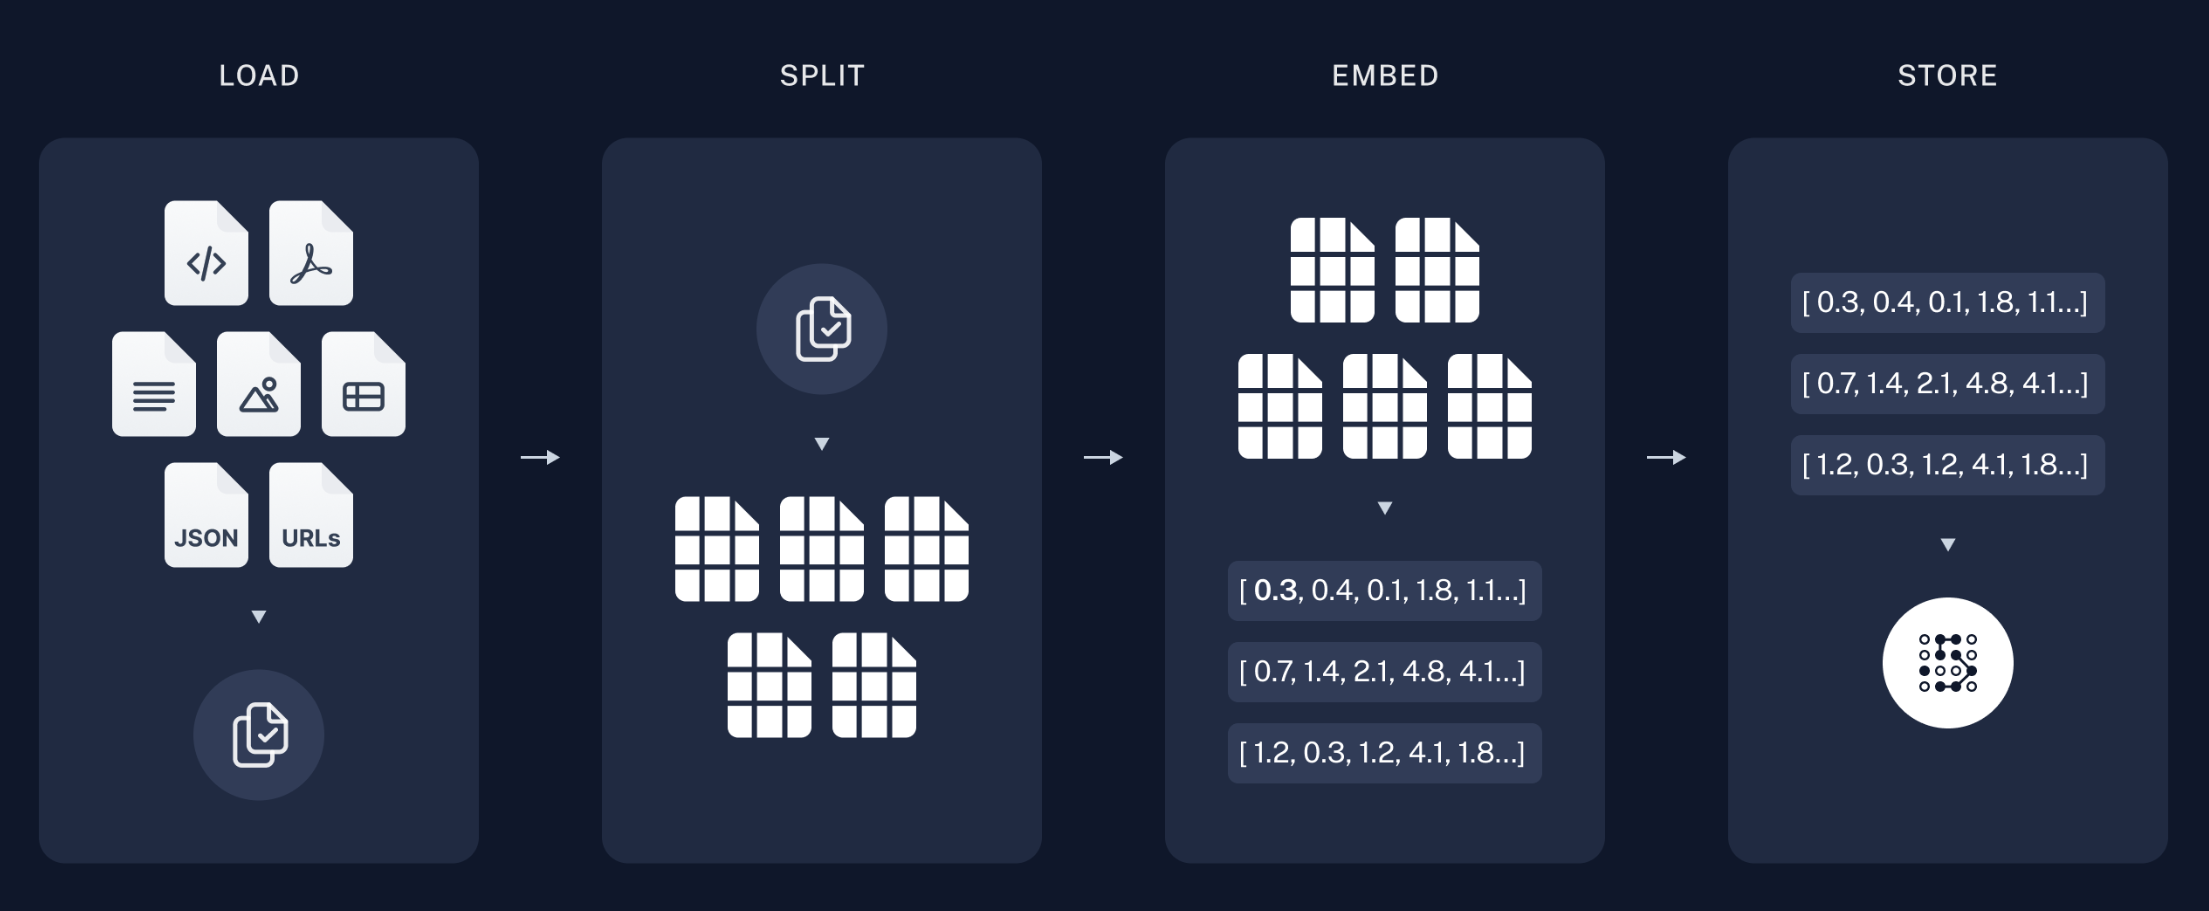
这一阶段通常包括:
- 加载(Load):把原始文件读成 LangChain 的
Document对象。 - 分割(Split):把长文档切成较小的片段,便于后续向量化和检索。
- 向量化(Embed):把每个文档片段转成向量。
- 存储(Store):把“片段内容 + 向量 + 元数据”写入向量数据库。
这里有两个很容易忽略的点:
索引通常是离线做的。
比如每天定时重建一次知识库,或在文档更新后增量写入;它不一定跟用户问答发生在同一时刻。索引不只是“存文本”。
它真正要存的是“文本片段 + 向量表示 + metadata”,这样后面才可能做相似检索、来源展示、条件过滤。
什么是 metadata?
metadata是和文档片段绑定的附加信息,例如文件路径source、页码page、标题、作者、日期、分类等。
在 RAG 里,真正参与向量化的是正文page_content;metadata更多用于来源展示、过滤条件、结果解释。
1.3.2 检索与生成阶段:每次提问时动态查资料
当用户真正发起问题时,系统进入第二阶段。这对应的就是原书第 2 章里“基于知识库提问 / 生成回答”的那部分能力,只不过这里我们要看清楚它在代码里究竟分成了哪几步:
- 用户输入问题。
- 把问题也向量化。
- 去向量库里找最相似的文档片段。
- 把这些片段作为
context放进 Prompt。 - 再把
context + question一起发给大模型生成答案。
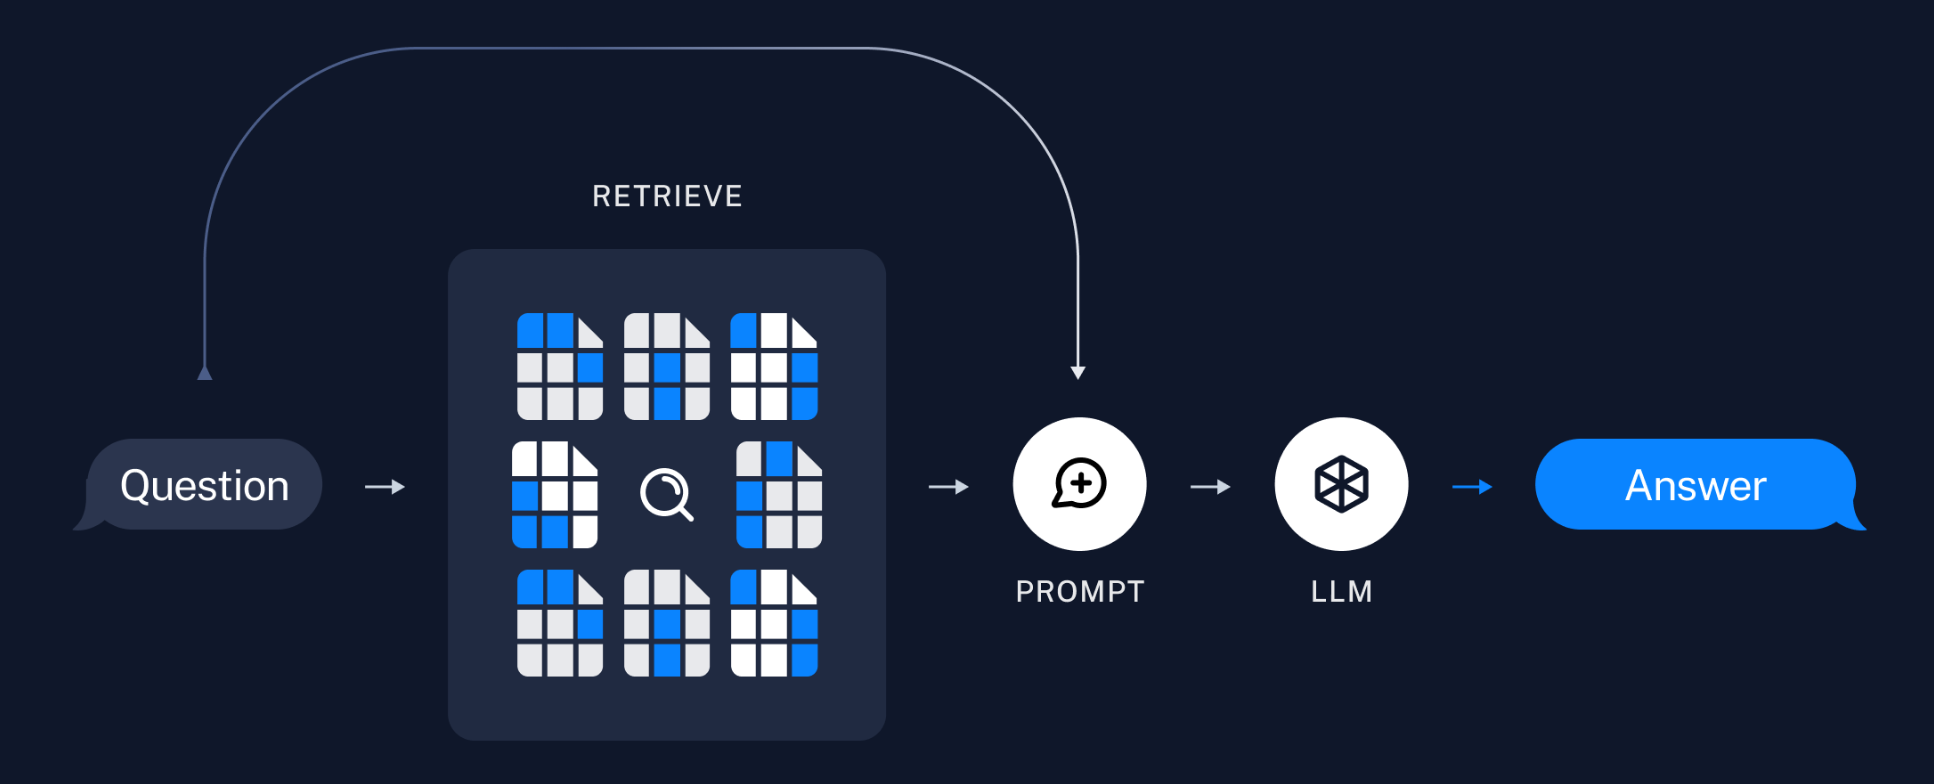
这一阶段的核心不是“再去建库”,而是“拿已经建好的索引来查资料”。也就是说:
- 索引阶段:提前备好资料库。
- 检索阶段:每次提问时现场查资料。
1.3.3 管道式 RAG 与 Agent 式 RAG
本教程这一章,重点是最经典、最容易上手的 管道式 RAG。它与 LangChain 官方文档中的 2-Step RAG 是同一类思路:先检索、再生成,流程由代码固定,而非由模型临时决策。
它的特点很明确:每次用户提问,系统都会先检索一次;是否检索不由模型临时决定,而是由你的代码流程提前写死;整体结构通常也是“检索器 + 提示词模板 + 聊天模型”的固定流水线。
这类方案适用于:企业知识库问答、文档问答、规范 / 手册 / FAQ 检索增强。
如果要让“模型自己决定要不要检索、什么时候检索、检索几次”,那就更接近 Agent 式 RAG(对应官方文档中的 Agentic RAG)。更完整的智能体编排会在后续 第 13 章 Agent 智能体 等章节展开;先把本章这种两阶段、单次检索、单次生成的主线学扎实更重要。
1.3.4 一个更贴近生产环境的增强版流程
如果只是入门,先把握前面的“两阶段”即可;但从真实项目角度看,很多 RAG 系统会在“检索与生成”之间再补几步,让结果更稳。原书第 2 章里你已经在 Dify 里看到了 Top K、Rerank、混合检索这些参数,这里可以把它们和代码链路对上:
- 先召回候选片段:检索器不一定只有向量检索,也可能是关键词、混合检索。
- 再做过滤或重排:按
metadata过滤范围,或用 reranker 对候选片段重新打分。 - 最后再进 Prompt:把更少但更相关的片段送给模型,而不是把一大堆噪声上下文都塞进去。
- 生成后保留来源:真实项目里常常会返回文件名、页码、片段来源,便于核验。
- 持续做评测与观测:离线看召回命中率、答案质量,线上看检索链路和生成链路谁在掉链子。
所以,RAG 不等于“向量库 + 大模型”这么简单。更完整的理解应该是:数据处理、检索策略、上下文组织、答案生成、来源追踪与效果评测共同组成了一条工程链路。
2、RAG 文本处理核心知识
2.1 LangChain 组件与标准流程
RAG 并不是某一个单独类就能完成的功能,它更像一条由多个组件拼起来的流水线。LangChain 的价值,正是在于它把这些组件都统一成了较一致的接口,方便我们按步骤搭起来。
本章最常见的组件分工如下:
| 组件 | 作用 | 常见类 / 说明 |
|---|---|---|
| Document | LangChain 中统一的文档对象 | 由 page_content + metadata 组成 |
| 文档加载器 | 从 TXT、PDF、Word、Markdown、JSON、CSV 等读入文档 | TextLoader、PyPDFLoader、UnstructuredWordDocumentLoader 等 |
| 文本分割器 | 把长文档切成较小片段 | RecursiveCharacterTextSplitter 最常见 |
| 嵌入模型 | 把文本片段转成向量 | 本项目常见 DashScopeEmbeddings |
| 向量数据库 | 存储向量并支持相似检索 | Redis / RedisStack、Chroma、FAISS 等 |
| 检索器 | 用户提问时从向量库召回相关片段 | 常见由 vector_store.as_retriever() 得到 |
| 提示词模板 | 把检索结果和用户问题组织成 Prompt | PromptTemplate、ChatPromptTemplate |
| 聊天模型 | 基于上下文生成最终答案 | ChatOpenAI、init_chat_model() 等 |
用面试里的说法,可以这样概括整个流程:
- 用文档加载器把原始文件转成
Document。 - 用文本分割器把长文档切成多个片段。
- 用嵌入模型把片段转成向量,并写入向量数据库。
- 用户提问时,把问题拿去做向量检索,得到相关片段。
- 把片段作为上下文,和用户问题一起填进 Prompt。
- 调用大模型,得到最终答案。
2.1.1 from_documents 与 add_texts:两种常见的入库方式
你在本仓库里会同时看到两种写法:from_documents(...)、add_texts(...)
它们都能把内容写入向量库,但适合的输入形态和工程语义不一样。
| 方法 | 更适合什么场景 | 你手里通常有什么数据 | 常见理解 |
|---|---|---|---|
from_documents | 已经完成“加载 + 分割”之后的一步入库 | Document 列表 | 更像“把文档片段整批建库” |
add_texts | 已经有向量库实例,需要持续追加内容 | 字符串列表 + 可选 metadata | 更像“往现有索引里追加文本” |
可以把它们看作两种数据入口,并不冲突,只取决于你手里现在是 Document 列表还是纯文本列表:
- 文档流驱动:
Loader -> Splitter -> List[Document] -> from_documents(...)(典型 RAG 建索引) - 纯文本流驱动:
texts + metadata -> add_texts(...)(接口落库、增量追加、脱离 Loader 的实验)
2.1.2 结合本章案例理解
本仓库里正好有两个很典型的案例,可以把这两个方法的区别讲得很清楚。
第一类:from_documents,对应完整 RAG 链路
在综合案例 EmbeddingRagLLM.py 里,流程是:
- 用
Docx2txtLoader加载alibaba-java.docx - 用
CharacterTextSplitter切分文档 - 得到一批切好的
Document - 调用
Redis.from_documents(...)直接写入向量库
这种写法非常贴近“真正的 RAG 业务流程”,因为:
- 你的知识原本就在文档里
- 文档先经过加载和切分
- 入库时保留了
Document结构 - 后续可以自然衔接
as_retriever()
也就是说,from_documents(...) 更像是“把已经准备好的知识片段整批建成索引”。
第二类:add_texts,对应单独演示向量库存取
在 RedisVectorStore.py 里,案例没有先走 Loader 和 Splitter,而是直接给出一组字符串 texts 与对应的 metadata,再按两步完成写入:
- 先创建
RedisVectorStore; - 再调用
add_texts(texts, metadata)写入。
这种写法更像是在演示:
- 向量库本身如何使用
- 纯文本如何批量入库
- 已有索引如何继续追加内容
所以它更适合拿来理解“向量存储层怎么工作”,也更适合做一些小规模实验、增量写入、脱离文档加载器的独立入库逻辑。
2.1.3 再往后一步:检索案例和它们是什么关系
RedisVectorStore_SimilaritySearch.py 虽然和上面两个文件放在一起,但它所在的其实是 RAG 的检索阶段,不是索引阶段。
它和前面两种写入方式的关系是:
- 先通过
from_documents(...)或add_texts(...)把数据写进向量库 - 再通过
similarity_search_with_score(...)去查库
所以这三个案例可以连起来理解成:
RedisVectorStore.py:怎么把文本写进去RedisVectorStore_SimilaritySearch.py:怎么把相关内容查出来EmbeddingRagLLM.py:怎么把“查出来的内容”再喂给大模型完成回答
这样看,三者就不是零散的小例子,而是 RAG 完整链路的三个片段。
2.1.4 入门时怎么选
如果你是刚开始学,建议按下面的顺序理解:
先把
add_texts(...)看懂
因为它更直接,容易理解“文本 -> 向量 -> 向量库”这件事。再看
from_documents(...)
因为它更贴近真实 RAG 项目,能把“文档加载、文本切分、向量化入库”串起来。最后把它们放回完整案例里理解
你会发现:RAG 的重点从来不只是“把内容存进去”,而是“存进去以后,如何在提问时检索出来,并和 Prompt、LLM 结合起来”。
【案例源码】案例与源码-2-LangChain框架/10-rag/RedisVectorStore.py(写入文本并存入 Redis)
"""
【案例】使用 langchain_redis 将文本写入 Redis 向量库(add_texts)

对应教程章节:第 11 章 - RAG 检索增强生成 → 2.1.1 from_documents 与 add_texts;也可与第 10 章向量库写入案例对照阅读

知识点速览:
- 这个案例展示的是纯文本流驱动的入库路线:先创建 `RedisVectorStore`,再通过 `add_texts()` 把字符串列表写入向量库。
- `add_texts(texts, metadata)` 会在内部调用 `embed_documents(texts)` 做批量向量化,然后把文本、向量和 metadata 一起写入 Redis。
- 这条路线和 `from_documents(...)` 并不冲突:前者更适合你手里已经是纯文本列表,后者更适合你已经有 `Document` 列表。
- 本例里额外手动执行了一次 `embed_documents`,目的是先观察“向量长什么样、维度是多少”;真正做存储时,这一步不是必须的。
- 返回的 ids 可用于后续更新、删除或追踪;index_name 需要和后续检索端保持一致。
"""

from langchain_redis import RedisConfig, RedisVectorStore
from langchain_community.embeddings import DashScopeEmbeddings
import os
from dotenv import load_dotenv

load_dotenv()

# 1. 初始化嵌入模型
embeddingsModel = DashScopeEmbeddings(
    model="text-embedding-v3", dashscope_api_key=os.getenv("aliQwen-api")
)

# 2. 待写入的文本及(可选)元数据
texts = [
    "我喜欢吃苹果",
    "苹果是我最喜欢吃的水果",
    "我喜欢用苹果手机",
]


# 批量转成向量:这里只是为了先观察向量维度和内容;真正写入时 add_texts 内部会再次完成向量化
embeddings = embeddingsModel.embed_documents(texts)
for i, vec in enumerate(embeddings, 1):
    print(f"文本 {i}: {texts[i-1]}")
    print(f"向量长度: {len(vec)}")
    print(f"前5个向量值: {vec[:10]}\n")

# 定义每条文本对应的元数据信息
# metadata = [{"segment_id": "1"}, {"segment_id": "2"}, {"segment_id": "3"}]

# 定义每条文本对应的元数据信息;真实 RAG 中这些 metadata 往往来自 Document.metadata,也可作为来源展示或过滤条件
metadata = [{"segment_id": str(i)} for i in range(1, len(texts) + 1)]

# 3. Redis 连接与索引名(需与检索案例一致)
config = RedisConfig(
    index_name="newsgroups",
    redis_url="redis://localhost:26379",
)

# 创建 Redis 向量存储实例:此时只是“连上库 + 指定索引配置”,还没真正写入文本;真正写入发生在 add_texts()
vector_store = RedisVectorStore(embeddingsModel, config=config)

# 4. 将文本与元数据写入向量库(add_texts 内部会调 embed_documents,无需先算向量)
ids = vector_store.add_texts(texts, metadata)

# 打印前5个存储记录的ID
print(ids[0:5])

"""
【输出示例】
文本 1: 我喜欢吃苹果
向量长度: 1024
前5个向量值: [-0.04062262922525406, 0.03663524612784386, -0.07420649379491806, 0.003861021716147661, -0.06338627636432648, -0.02864176034927368, -0.027855515480041504, 0.03684116527438164, -0.023493731394410133, -0.027892956510186195]

文本 2: 苹果是我最喜欢吃的水果
向量长度: 1024
前5个向量值: [-0.03398064523935318, 0.04141449183225632, -0.06892527639865875, 0.005737593863159418, -0.06951850652694702, -0.04560413956642151, -0.04171110317111015, 0.04508506879210472, -0.04549290984869003, -0.017945043742656708]

文本 3: 我喜欢用苹果手机
向量长度: 1024
前5个向量值: [-0.052530914545059204, 0.006213586777448654, -0.11318981647491455, -0.023480866104364395, -0.036481890827417374, -0.04383847862482071, 0.005418661516159773, 0.02874900959432125, 0.0019732017535716295, 0.01118539646267891]

['newsgroups:01KKDZ5MRGBDPWJHDZZWH4W2Q6', 'newsgroups:01KKDZ5MRGBDPWJHDZZWH4W2Q7', 'newsgroups:01KKDZ5MRGBDPWJHDZZWH4W2Q8']
"""【案例源码】案例与源码-2-LangChain框架/10-rag/RedisVectorStore_SimilaritySearch.py(相似性检索)
"""
【案例】在 Redis 向量库中做相似性检索(similarity_search_with_score)

对应教程章节:第 11 章 - RAG 检索增强生成 → 2.1.3 再往后一步:检索案例和它们是什么关系;也可与第 10 章相似检索案例对照阅读

知识点速览:
- 这个案例对应的是 RAG 的检索阶段:前提是索引已经建好,现在要做的是“把相关内容查出来”。
- 相似性检索的核心流程是:查询文本先向量化,再到向量库中找到与查询向量最接近的若干条记录。
- `similarity_search_with_score(query, k)` 返回 `(Document, score)` 列表;很多实现里 score 更接近“距离”,通常越小越相似。
- 代码里把 score 换算成 1 - score,主要是为了更符合初学者直觉;真实项目里应以具体向量库和距离度量定义为准。
- 运行前需确保 Redis 中已有数据,例如先执行同目录下的 RedisVectorStore.py;`index_name`、`redis_url` 也必须保持一致。
- 在完整 RAG 里,这一步通常不会直接把结果打印完就结束,而是会把查到的 `Document` 进一步组织进 Prompt,再交给 LLM 生成答案。
"""

from langchain_redis import RedisConfig, RedisVectorStore
from langchain_community.embeddings import DashScopeEmbeddings
import os
from dotenv import load_dotenv

load_dotenv()

# 1. 嵌入模型(与写入时一致,保证向量空间一致);需在 .env 中配置 aliQwen-api
embeddingsModel = DashScopeEmbeddings(
    model="text-embedding-v3", dashscope_api_key=os.getenv("aliQwen-api")
)

# 2. 连接已有索引(与 RedisVectorStore.py 中 index_name、redis_url 一致)
vector_store = RedisVectorStore(
    embeddingsModel,
    config=RedisConfig(index_name="newsgroups", redis_url="redis://localhost:26379"),
)

# 3. 查询文本 → 向量化 → 在库中做相似度检索;这里取前 3 条结果
query = "我喜欢用什么手机"
results = vector_store.similarity_search_with_score(query, k=3)

print("=== 查询结果 ===")
for i, (doc, score) in enumerate(results, 1):
    # 这里把“距离”近似换算成“相似度”只是为了展示更直观;工程里请以具体返回定义为准
    similarity = 1 - score
    print(f"结果 {i}:")
    print(f"内容: {doc.page_content}")
    print(f"元数据: {doc.metadata}")
    print(f"相似度: {similarity:.4f}")

"""
【输出示例】
=== 查询结果 ===
结果 1:
内容: 我喜欢用苹果手机
元数据: {'segment_id': '3'}
相似度: 0.8594
结果 2:
内容: 我喜欢用苹果手机
元数据: {'segment_id': '3'}
相似度: 0.8594
结果 3:
内容: 我喜欢吃苹果
元数据: {'segment_id': '1'}
相似度: 0.6610
"""
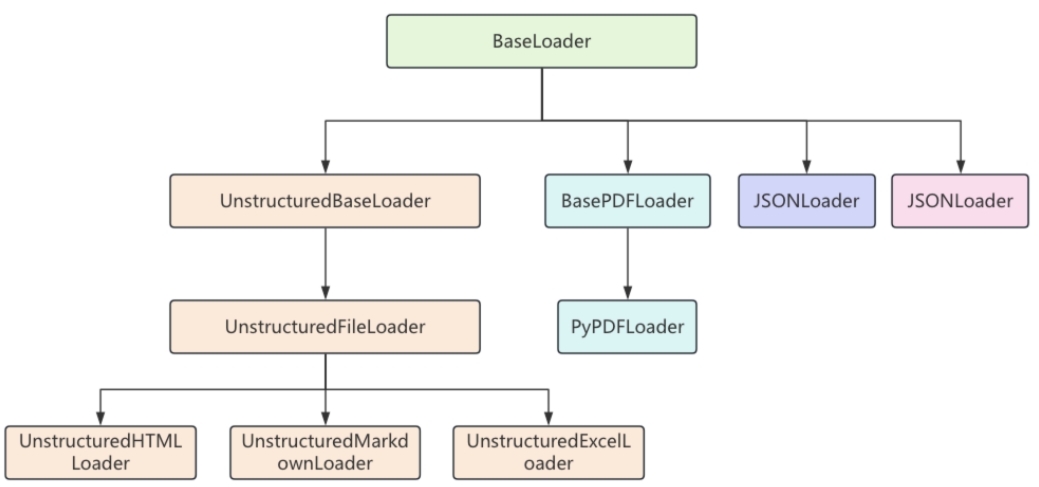
2.2 文档加载器(Document Loaders)
RAG 的第一步,往往不是“接模型”,而是“把你的知识读进来”。文档加载器的职责,就是把不同来源的数据统一转换成 LangChain 的 Document 格式。
LangChain 官方对文档加载器的定位很明确:它们为不同数据源提供了统一读取接口,最终都转成 Document。因此,无论你面对的是本地文件、企业文档平台、网页、数据库还是第三方系统,后续都能用统一方式进入切分、向量化和检索流程。
先记住两个统一接口就够了:
load():一次性加载全部文档lazy_load():按需流式加载,适合大文件或大批量数据
2.2.1 统一成 Document 的意义
Document 是 LangChain 在 RAG 里的基础数据结构,它通常有两个核心字段:
page_content:正文内容metadata:来源、页码、文件名、分类等附加信息
有些实现或版本里,你还会看到可选的 id 字段,用来标识文档或文档片段。这样设计的好处是,后面的分割器、向量库、检索器都不需要关心“这段内容最初来自 PDF 还是 CSV”,它们只需要面向统一的 Document 处理即可。
这也是为什么你会经常看到这样的链路:
原始文件 -> Loader -> List[Document] -> TextSplitter -> VectorStore
2.2.2 如何选择加载器
选择加载器时,不要一开始就背几十个类名,先抓住两个原则:
先按文件类型选
- TXT 用
TextLoader - PDF 用
PyPDFLoader - Word 用
UnstructuredWordDocumentLoader或Docx2txtLoader - Markdown 用
UnstructuredMarkdownLoader - JSON 用
JSONLoader - CSV 用
CSVLoader
- TXT 用
再按解析精度和成本选
- 想快速跑通案例,优先选依赖少、接口直接的加载器
- 想保留更丰富版面结构、标题层级、表格信息,再考虑更强的解析器
比如本章综合案例 EmbeddingRagLLM.py 用的是 Docx2txtLoader,因为它足够直接、适合快速把 alibaba-java.docx 读入并跑通端到端 RAG;
而单独的 Word 加载案例 RagLoadDocDemo.py 则使用了 UnstructuredWordDocumentLoader,更适合说明“不同文件格式可以统一进入 RAG 流程”。
如果以后你在真实项目里遇到更复杂的 PDF、扫描件、表格型文档,通常还会引入 OCR、版面分析工具、专门的 PDF 解析服务等更强的方案。这部分已经超出本章案例范围,但你需要先建立一个判断:RAG 效果好不好,很多时候不是模型先出问题,而是文档解析质量先决定了一半。
2.2.3 文档加载器案例
下面这些案例都在 10-rag/docloads/ 目录下,建议你按文件格式逐个跑一遍。学习重点不是死记类名,而是观察:无论加载什么文件,输出都会进入同一种 Document 结构。
- TXT(纯文本)
【案例源码】案例与源码-2-LangChain框架/10-rag/docloads/RagLoadTxtDemo.py
"""
【案例】用 TextLoader 加载纯文本(TXT)为 Document 列表

对应教程章节:第 11 章 - RAG 检索增强生成 → 2、RAG 文本处理核心知识

知识点速览:
- 文档加载器负责把各种格式的文件读成 LangChain 的 Document;每个 Document 有 page_content(正文)和 metadata(如 source 路径)。
- TextLoader 用于纯文本(.txt),需指定文件路径和编码(如 utf-8);load() 返回 List[Document],多行文本通常合并为一个 Document。
- TXT 是最容易入门的加载场景,但“能加载”不等于“适合直接检索”:真实 RAG 中通常仍要继续切块,再做向量化与入库。
- 后续可接文本分割器、嵌入模型与向量库,完成 RAG 的「加载 → 分割 → 向量化 → 存储」流程。
"""

from pathlib import Path

# pip install langchain_community
from langchain_community.document_loaders import TextLoader

file_path = Path(__file__).resolve().parent / "assets" / "sample.txt"
encoding = "utf-8"

# load() 为 BaseLoader 统一接口,返回 List[Document]
docs = TextLoader(file_path, encoding).load()

print(docs)
"""
【输出示例】
[Document(metadata={'source': 'assets/sample.txt'}, page_content='LangChain 是一个用于构建基于大语言模型(LLM)应用的开发框架,旨在帮助开发者更高效地集成、管理和增强大语言模型的能力,构建端到端的应用程序。它提供了一套模块化工具和接口,支持从简单的文本生成到复杂的多步骤推理任务。')]
"""【案例源码】案例与源码-2-LangChain框架/10-rag/docloads/RagLoadPdfDemo.py
"""
【案例】用 PyPDFLoader 加载 PDF 为 Document 列表

对应教程章节:第 11 章 - RAG 检索增强生成 → 2、RAG 文本处理核心知识

知识点速览:
- PDF 需专用加载器;PyPDFLoader 支持本地路径或在线 URL,extraction_mode 可选 plain(纯文本)或 layout(按版面)。
- 每页通常对应一个 Document,metadata 中会带页码等信息,便于后续检索时定位来源。
- PDF 往往是文档解析里最麻烦的一类:同样是“能读出来”,不代表读出来的结构就一定适合直接做 RAG,因此很多项目里还会继续接切块、清洗,甚至更强的 PDF 解析工具。
- 若需更好排版与表格识别,可了解 Unstructured 等库的 PDF 加载器(见教程 2.2 常用加载器表)。
- 为何没 import pypdf 却要装 pypdf?PyPDFLoader 在 langchain_community 内部会「按需」import pypdf 来解析 PDF,langchain-community 不自动安装它,所以需单独 pip install pypdf。
"""

from pathlib import Path

# pip install langchain_community pypdf
from langchain_community.document_loaders import PyPDFLoader

pdf_path = Path(__file__).resolve().parent / "assets" / "sample.pdf"
docs = PyPDFLoader(
    file_path=pdf_path,
    extraction_mode="plain",  # plain 纯文本;layout 按版面
).load()

print(docs)
"""
【输出示例】
[Document(metadata={'producer': 'Microsoft® Word 2019', 'creator': 'Microsoft® Word 2019', 'creationdate': '2023-07-24T17:46:07+08:00', 'title': '中国科学院国家天文台2023年度部门预算', 'author': 'MC SYSTEM', 'moddate': '2023-07-24T17:46:07+08:00', 'source': 'assets/sample.pdf', 'total_pages': 36, 'page': 0, 'page_label': '1'}, page_content='中国科学院国家天文台 \n2023 年部门预算'), Document(metadata={'producer': 'Microsoft® Word 2019', 'creator': 'Microsoft® Word 2019', 'creationdate': '2023-07-24T17:46:07+08:00', 'title': '中国科学院国家天文台2023年度部门预算', 'author': 'MC SYSTEM', 'moddate': '2023-07-24T17:46:07+08:00', 'source': 'assets/sample.pdf', 'total_pages': 36, 'page': 1, 'page_label': '2'}, page_content='目……
"""- Word(.docx)
【案例源码】案例与源码-2-LangChain框架/10-rag/docloads/RagLoadDocDemo.py
"""
【案例】用 UnstructuredWordDocumentLoader 加载 Word(.docx)为 Document 列表

对应教程章节:第 11 章 - RAG 检索增强生成 → 2、RAG 文本处理核心知识

知识点速览:
- .docx 需专用加载器;UnstructuredWordDocumentLoader 的 mode 可选 single(整篇一个 Document)或 elements(按标题等元素切分)。
- Word 文档虽然本质上是机器可读的结构化文件,但现实里标题样式和段落样式常常不够规范,所以“视觉上像标题”不一定能被稳定识别。
- 为何要装 unstructured?UnstructuredWordDocumentLoader 内部会按需 import unstructured 解析 .docx,langchain-community 不自动安装,需单独 pip install unstructured(若只加载 docx 可装 unstructured[docx])。
- `single` 更适合快速看整篇内容;`elements` 更适合理解“按结构拆成多个 Document”的效果。加载后得到 `List[Document]`,与 TXT/PDF 等一致,可统一走「分割 → 向量化 → 入库」流程。
"""

from pathlib import Path

# pip install langchain_community unstructured[docx] python-docx
from langchain_community.document_loaders import UnstructuredWordDocumentLoader

document_path = Path(__file__).resolve().parent / "assets" / "alibaba-more.docx"
docs = UnstructuredWordDocumentLoader(
    file_path=document_path,
    mode="single",  # single 整篇一个 Document;elements 按元素切分
).load()

print(docs)
"""
【输出示例】
[Document(metadata={'source': 'assets/alibaba-more.docx'}, page_content='Java开发手册(黄山版)\n\nJava开发手册(黄山版)\n\n前言 \n\n《Java 开发手册》是阿里巴巴技术团队的集体智慧结晶和经验总结,经历了多次大规模一线实战的检验及不断完善,公开到业界后,众多社区开发者踊跃参与打磨完善,系统化地整理成册,当前的最新版本是黄山版。现代软件行业的高速发展对开发者的综合素质要求越来越高,因为不仅是编程知识点,其它维度的知识点也会影响到软件的最终交付质量。比如:五花八门的错误码会人为地增加排查问题的难度;数据库的表结构和索引设计缺陷带来的系统架构缺陷或性能风险;工程结构混乱导致后
"""- Markdown
【案例源码】案例与源码-2-LangChain框架/10-rag/docloads/RagLoadMarkdownDemo.py
"""
【案例】用 UnstructuredMarkdownLoader 加载 Markdown 为 Document 列表

对应教程章节:第 11 章 - RAG 检索增强生成 → 2、RAG 文本处理核心知识

知识点速览:
- Markdown 是一种典型的半结构化文本:天然带有标题、列表、段落等结构,因此很适合做知识库文档。
- Markdown 可用 UnstructuredMarkdownLoader;mode 为 elements 时会按标题、段落等元素拆成多个 Document,便于保留结构。
- 适合技术文档、README 等;后续分割时也可选用 MarkdownHeaderTextSplitter 按标题切分(见 2.3 文本分割器表)。
"""

from pathlib import Path

# pip install langchain_community unstructured[md]
from langchain_community.document_loaders import UnstructuredMarkdownLoader

markdown_path = Path(__file__).resolve().parent / "assets" / "sample.md"
docs = UnstructuredMarkdownLoader(
    file_path=markdown_path,
    mode="elements",  # single 整篇;elements 按元素切分
).load()

print(docs)
"""
【输出示例】
[Document(metadata={'source': 'assets/sample.md', 'category_depth': 0, 'languages': ['ron'], 'file_directory': 'assets', 'filename': 'sample.md', 'filetype': 'text/markdown', 'last_modified': '2026-03-10T10:36:41', 'category': 'Title', 'element_id': 'e6a3b421f39f298fffbc3cf1b3b95817'}, page_content='投机解码(Speculative Decoding)介绍'), Document(metadata={'source': 'assets/sample.md', 'category_depth': 1, 'languages': ['kor'], 'file_directory': 'assets', 'filename': 'sample.md', 'filetype': 'text/markdown', 'last_modified': '2026-03-10T10:36:41', 'parent_id': 'e6a3b421f39f298fffbc3cf1b3b95817', 'category': 'Title', 'element_id': '3a77bcc407e48690734a4701557ffdb6'}, page_content='引言'), Document(metadata={'source': 'assets/sample.md', 'languages': ['nor', 'vie', 'zho'], 'file_directory': 'assets', 'filename': 'sample.md', 'filetype': 'text/markdown', 'last_modified': '2026-03-10T10:36:41', 'parent_id': '3a77bcc407e48690734a4701557ffdb6', 'category': 'UncategorizedText', 'element_id': '5a9685df7e44c7f338356ef37bc09149'}, page_content='投机解码(Speculative Decoding)是……
"""- JSON
【案例源码】案例与源码-2-LangChain框架/10-rag/docloads/RagLoadJsonDemo.py
"""
【案例】用 JSONLoader 加载 JSON 文件为 Document 列表

对应教程章节:第 11 章 - RAG 检索增强生成 → 2、RAG 文本处理核心知识

知识点速览:
- JSONLoader 通过 jq_schema 指定要提取的 JSON 路径(如 "." 表示整份、".key" 表示某字段);text_content 控制是否把内容当作文本。
- `jq_schema="."` 表示把整份 JSON 当成一条内容读取,适合演示;真实 RAG 中通常会抽取更具体的字段或列表项,避免“一个 JSON 文件只变成一个很大的 Document”。
- 依赖 jq:pip install jq;若 JSON 较复杂可先查看文档确定 jq_schema 写法。
- 返回的每个 Document 对应一条被提取出的内容,便于后续向量化与检索。
"""

from pathlib import Path

# pip install jq langchain_community
from langchain_community.document_loaders import JSONLoader

json_path = Path(__file__).resolve().parent / "assets" / "sample.json"
docs = JSONLoader(
    file_path=json_path,
    jq_schema=".",  # 提取所有字段
    text_content=False,  # 是否按字符串处理内容
).load()

print(docs)

"""
【输出示例】
[Document(metadata={'source': '/Users/tools/Desktop/agent/ai-agents-from-zero/案例与源码-2-LangChain框架/10-rag/docloads/assets/sample.json', 'seq_num': 1}, page_content='{"status": "success", "data": {"page": 2, "per_page": 3, "total_pages": 5, "total_items": 14, "items": [{"id": 101, "title": "Understanding JSONLoader", "content": "This article explains how to parse API responses...", "author": {"id": "user_1", "name": "Alice"}, "created_at": "2023-10-05T08:12:33Z"}, {"id": 102, "title": "Advanced jq Schema Patterns", "content": "Learn to handle nested structures with...", "author": {"id": "user_2", "name": "Bob"}, "created_at": "2023-10-05T09:15:21Z"}, {"id": 103, "title": "LangChain Metadata Handling", "content": "Best practices for preserving metadata...", "author": {"id": "user_3", "name": "Charlie"}, "created_at": "2023-10-05T10:03:47Z"}]}}')]
"""- CSV
【案例源码】案例与源码-2-LangChain框架/10-rag/docloads/RagLoadCSVDemo.py
"""
【案例】用 CSVLoader 加载 CSV 为 Document 列表

对应教程章节:第 11 章 - RAG 检索增强生成 → 2、RAG 文本处理核心知识

知识点速览:
- CSVLoader 按行加载,每行可转成一个 Document。
- 不指定列时:整行(所有列)会拼成一条字符串作为 page_content,metadata 通常只有 source,检索时整行一起被向量化。
- 指定 `content_columns` + `metadata_columns` 时:只有指定列作为正文(page_content),其余列进 metadata;这正好对应了 RAG 里 `Document.page_content` 与 `Document.metadata` 的分工。
- 检索时只对正文向量化,metadata 更适合拿来做过滤、来源展示和结果解释,因此结构化表格数据尤其适合这样拆分。
"""

from pathlib import Path

# pip install langchain_community
from langchain_community.document_loaders.csv_loader import CSVLoader

# 基于脚本位置定位测试文件,避免受当前工作目录影响
csv_path = Path(__file__).resolve().parent / "assets" / "sample.csv"

# 方式一:不指定列 → 整行(所有列)拼成一条字符串作为 page_content,metadata 通常只有 source 等
docs_all = CSVLoader(file_path=csv_path).load()
print("=== 方式一:整行作为 page_content ===")
print(
    "page_content 示例:",
    (
        docs_all[0].page_content[:80] + "..."
        if len(docs_all[0].page_content) > 80
        else docs_all[0].page_content
    ),
)
print("metadata 示例:", docs_all[0].metadata, "\n")

# 方式二:指定 content_columns 与 metadata_columns → 正文只取 content 列,title/author 进 metadata,便于检索时按作者/标题过滤
docs_split = CSVLoader(
    file_path=csv_path,
    metadata_columns=["title", "author"],
    content_columns=["content"],
).load()
print("=== 方式二:content 列作为正文,title/author 进 metadata ===")
print("page_content 示例:", docs_split[0].page_content)
print("metadata 示例:", docs_split[0].metadata)


"""
【输出示例】
=== 方式一:整行作为 page_content ===
page_content 示例: id: 1
title: Introduction to Python
content: Python is a popular programming lan...
metadata 示例: {'source': 'assets/sample.csv', 'row': 0}

=== 方式二:content 列作为正文,title/author 进 metadata ===
page_content 示例: content: Python is a popular programming language.
metadata 示例: {'source': 'assets/sample.csv', 'row': 0, 'title': 'Introduction to Python', 'author': 'John Doe'}
"""
2.3 文本分割器(Text Splitters)
文档加载之后,通常还不能直接拿去建 RAG。原因很简单:原始文档经常太长。
这会带来两个现实问题:
- 检索效果差:整篇文档太大,向量表达会过于粗糙,难以精确定位到真正相关的小段内容。
- 生成成本高:就算检索回来整篇文档,也很可能塞不进模型上下文,或者把大量无关内容一并送给模型。
所以,RAG 中几乎都会有“切块(chunking)”这一步。
LangChain 官方也明确建议:面对通用文本时,RecursiveCharacterTextSplitter 往往是最推荐的入门分割器。它会尽量优先保留较大的语义单位,例如段落、句子;如果某一段还太长,再继续往更小层级切。
2.3.1 为什么要切块
切块的本质,就是把大文档拆成多个更容易参与检索的小段。这样做之后,系统更容易只召回真正相关的片段,也更容易控制每次送给模型的上下文长度;无关内容变少后,干扰会下降,后面做来源标注和精确引用也会更方便。
在真实项目里,切块策略会直接影响 RAG 的最终效果。很多时候不是模型不行,而是:
- 块切得太大,相关信息被淹没
- 块切得太小,语义被切碎
- 没有重叠,导致一句话被拦腰截断
所以,分割策略本身就是 RAG 质量的重要一环。
还有一个很关键的现实点:即使某些大模型已经支持长上下文,也不意味着“把整篇文档直接塞进去”就是好方案。因为上下文越长,越容易混入无关信息,也越容易让真正关键的内容被稀释。RAG 里的“切块 + 检索”,本质上是在帮模型先做一轮信息筛选。
2.3.2 常见分割器与适用场景
| 分割器 | 作用 |
|---|---|
| RecursiveCharacterTextSplitter | 通用首选,优先保持较大语义单位,必要时递归切得更细 |
| CharacterTextSplitter | 按指定分隔符切,简单直接 |
| MarkdownHeaderTextSplitter | 按 Markdown 标题层级切分 |
| HTMLHeaderTextSplitter | 按 HTML 标题结构切分 |
| TokenTextSplitter | 按 token 数控制块大小,更贴近模型上下文限制 |
| 语义切分(Semantic Chunking) | 按语义变化切分,尽量让相关内容保留在同一块中,但成本更高、实现更复杂 |
| 代码类分割器 | 按函数、类、逻辑块切分代码文本 |
本章案例主线,还是以 RecursiveCharacterTextSplitter 为主,因为它最适合帮助你建立“分块”这件事的直觉。
这里补充一个真实项目里的判断:切分策略不是越高级越好,而是要看“值不值得”。像语义切分这种方案,理论上更有机会保留完整语义,但它往往需要额外的向量计算或更复杂的实现。对于初学者和大多数入门项目来说,先把 RecursiveCharacterTextSplitter 用好,通常比一开始就追求复杂切分更重要。
2.3.3 重点参数理解
RecursiveCharacterTextSplitter 最常用的是下面几个参数:
| 参数 | 含义 | 实践理解 |
|---|---|---|
chunk_size | 单块最大长度 | 块太大不利于检索,块太小又容易语义碎片化 |
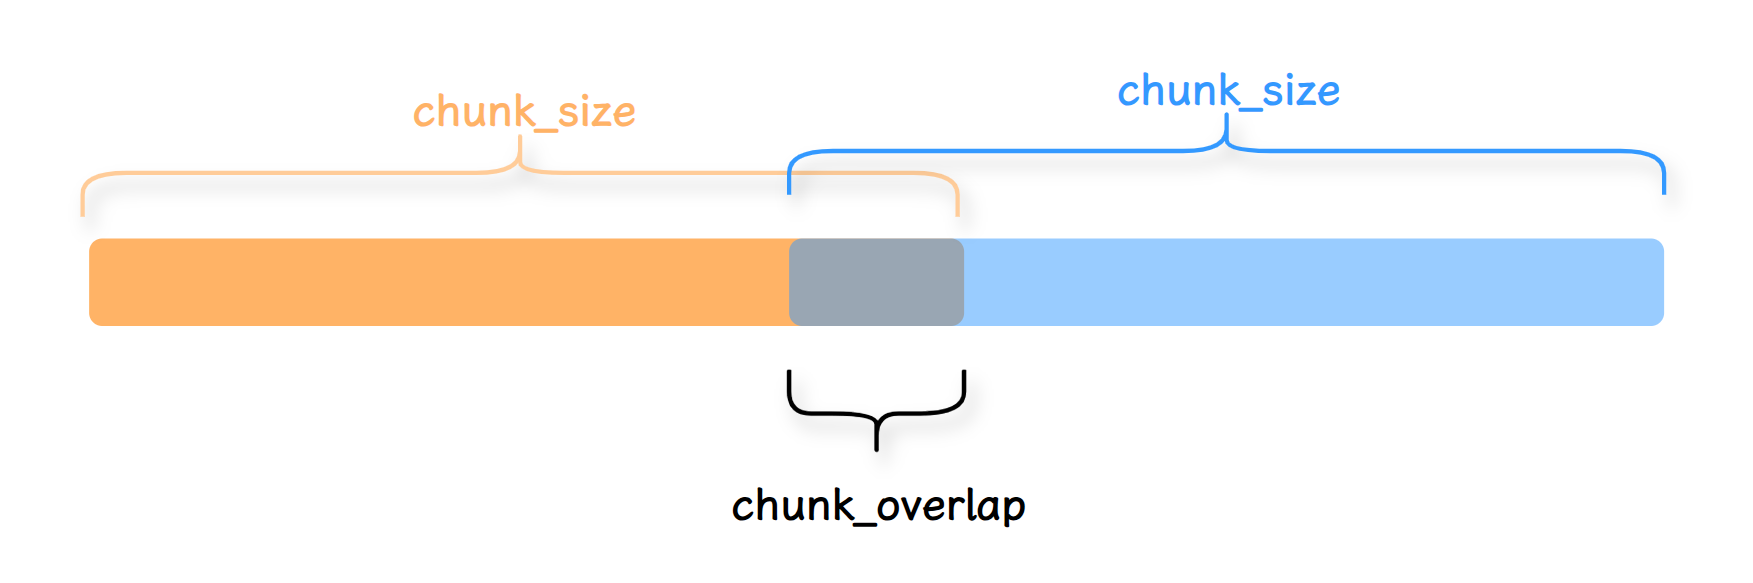
chunk_overlap | 相邻块重叠长度 | 防止句子、语义被截断,常见取块大小的 10%~20% |
length_function | 长度计算方式 | 默认常用 len,即按字符数;也可按 token 数 |
separators | 优先切分分隔符 | 决定先按段落、换行、句号还是更细粒度去切 |
对初学者来说,先把下面这条经验记住就够用了:
- 通用文档问答:优先用
RecursiveCharacterTextSplitter - 先调
chunk_size和chunk_overlap - 跑通后再逐步优化切分规则
真实项目里,不存在一个“永远最优”的块大小。它和文档类型、语言、问答粒度、模型上下文长度都有关系。学习时先跑通主链路,再基于效果调参,是更现实的路线。
2.3.4 文本分割器案例
- 分割纯文本
【案例源码】案例与源码-2-LangChain框架/10-rag/textsplit/RecursiveTextSplitter.py
"""
【案例】用 RecursiveCharacterTextSplitter 分割纯文本(split_text + create_documents)

对应教程章节:第 11 章 - RAG 检索增强生成 → 2、RAG 文本处理核心知识

知识点速览:
- 大文档需先切块再向量化:避免超长上下文、控制 token 成本;即使模型支持长上下文,也不代表把整篇文档直接塞进去就是更好的 RAG 方案。
- RecursiveCharacterTextSplitter 按字符递归切,尽量保持语义完整,是通用文本场景里最常见的入门分割器。
- chunk_size:单块最大长度(按 length_function 计算,默认 len 即字符数);chunk_overlap:相邻块重叠字符数,常用 size 的 10%~20%。
- split_text(content):把字符串切成字符串列表;create_documents(texts):把字符串列表转成 Document 列表(或直接用 split_documents 处理 Document)。
- 重叠部分会重复出现在相邻块中,总字符数会大于原文,这不是 bug,而是为了减少「半句话被截断」的问题。
"""

from langchain_text_splitters import RecursiveCharacterTextSplitter

# 1. 待分割的原文
content = (
    "大模型RAG(检索增强生成)是一种结合生成模型与外部知识检索的技术,通过从大规模文档或数据库中检索相关信息,"
    "辅助生成模型以提升回答的准确性和相关性。其核心流程包括用户输入查询、系统检索相关知识、"
    "生成模型基于检索结果生成内容,并输出最终答案。RAG的优势在于能够弥补生成模型的知识盲区,"
    "提供更准确、实时和可解释的输出,广泛应用于问答系统、内容生成、客服、教育和企业领域。"
    "然而,其也面临依赖高质量知识库、可能的响应延迟、较高的维护成本以及数据隐私等挑战。"
)

# 2. 分割器:块大小 100 字符,重叠 30 字符,长度按 len(字符数)计算
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=100, chunk_overlap=30, length_function=len
)

# 3. 先切成字符串列表
splitter_texts = text_splitter.split_text(content)

# 4. 再转成 Document 列表(便于后续与向量库、检索器对接)
splitter_documents = text_splitter.create_documents(splitter_texts)

print(f"原始文本大小:{len(content)}")
print(f"分割文档数量:{len(splitter_documents)}")
for splitter_document in splitter_documents:
    print(
        f"文档片段大小:{len(splitter_document.page_content)},文档内容:{splitter_document.page_content}"
    )

"""
【输出示例】
"""
"""
原始文本大小:225

分割文档数量:3

文档片段大小:100,文档内容:大模型RAG(检索增强生成)是一种结合生成模型与外部知识检索的技术,通过从大规模文档或数据库中检索相关信息,辅助生成模型以提升回答的准确性和相关性。其核心流程包括用户输入查询、系统检索相关知识、生成模

文档片段大小:100,文档内容:相关性。其核心流程包括用户输入查询、系统检索相关知识、生成模型基于检索结果生成内容,并输出最终答案。RAG的优势在于能够弥补生成模型的知识盲区,提供更准确、实时和可解释的输出,广泛应用于问答系统、内容

文档片段大小:85,文档内容:区,提供更准确、实时和可解释的输出,广泛应用于问答系统、内容生成、客服、教育和企业领域。然而,其也面临依赖高质量知识库、可能的响应延迟、较高的维护成本以及数据隐私等挑战。
"""

"""
验证总字符的逻辑(并非简单相加)
同学们可能会疑惑:100+100+85=285,比原始 225 多了 60,why?
这是因为重叠部分被重复计算了,实际原始文本的有效内容被完整覆盖,且无丢失:
第 1 块和第 2 块的重叠:30 字符(重复计算 1 次)
第 2 块和第 3 块的重叠:30 字符(重复计算 1 次)
总重复计算:60 字符 → 285 - 60 = 225(和原始文本长度一致)

这正是分割器设计 chunk_overlap 的目的:
以 “重复计算重叠部分” 为代价,保证每个文本块的语义完整性,避免分割切断上下文。
"""- 分割纯文本(V2:验证重叠与完整性)
【案例源码】案例与源码-2-LangChain框架/10-rag/textsplit/RecursiveTextSplitterV2.py
"""
【案例】RecursiveCharacterTextSplitter 分割纯文本并验证重叠与完整性(V2)

对应教程章节:第 11 章 - RAG 检索增强生成 → 2、RAG 文本处理核心知识

知识点速览:
- split_text() 得到字符串列表后,可手动用 `[Document(page_content=text) for text in texts]` 转成 Document;这是一种更显式的教学写法,不代表 create_documents 有问题。
- 和 `RecursiveTextSplitter.py` 相比,这个脚本的重点不是“如何切分”,而是“如何验证 chunk_overlap 带来的重叠并没有造成内容丢失”。
- chunk_overlap 会使相邻块有重复片段;若按「剔除重叠长度」再拼接,可验证是否覆盖原文且无丢失(本示例用固定 30 字符剔除演示)。
- 入门时以 RecursiveTextSplitter.py 的 split_text + create_documents 为主即可;本脚本侧重理解重叠与完整性。
"""

from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_core.documents import Document

content = (
    "大模型RAG(检索增强生成)是一种结合生成模型与外部知识检索的技术,通过从大规模文档或数据库中检索相关信息,"
    "辅助生成模型以提升回答的准确性和相关性。其核心流程包括用户输入查询、系统检索相关知识、"
    "生成模型基于检索结果生成内容,并输出最终答案。RAG的优势在于能够弥补生成模型的知识盲区,"
    "提供更准确、实时和可解释的输出,广泛应用于问答系统、内容生成、客服、教育和企业领域。"
    "然而,其也面临依赖高质量知识库、可能的响应延迟、较高的维护成本以及数据隐私等挑战。"
)

text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=100, chunk_overlap=30, length_function=len
)

# 先 split_text,再手动转 Document:这里这样写只是为了把“字符串块 -> Document”这一步显式展示出来
splitter_texts = text_splitter.split_text(content)
splitter_documents = [Document(page_content=text) for text in splitter_texts]

# 剔除重叠部分后拼接,用于验证与原文一致;这里直接写死 30,是因为前面 chunk_overlap=30
full_content = ""
for text in splitter_texts:
    if full_content:
        full_content += text[30:]
    else:
        full_content += text

print(f"原始文本大小:{len(content)},原始内容:\n{content}\n")
print(f"分割文档数量:{len(splitter_documents)}\n")
for idx, splitter_document in enumerate(splitter_documents, 1):
    print(
        f"第{idx}个文档 - 大小:{len(splitter_document.page_content)}, 内容:{splitter_document.page_content}\n"
    )

print(f"拼接后文本大小:{len(full_content)}")
print(f"是否与原始文本完全一致:{full_content == content}")
print(f"拼接后完整内容:\n{full_content}")


"""
【输出示例】
始文本大小:225,原始内容:
大模型RAG(检索增强生成)是一种结合生成模型与外部知识检索的技术,通过从大规模文档或数据库中检索相关信息,辅助生成模型以提升回答的准确性和相关性。其核心流程包括用户输入查询、系统检索相关知识、生成模型基于检索结果生成内容,并输出最终答案。RAG的优势在于能够弥补生成模型的知识盲区,提供更准确、实时和可解释的输出,广泛应用于问答系统、内容生成、客服、教育和企业领域。然而,其也面临依赖高质量知识库、可能的响应延迟、较高的维护成本以及数据隐私等挑战。

分割文档数量:3

第1个文档 - 大小:100, 内容:大模型RAG(检索增强生成)是一种结合生成模型与外部知识检索的技术,通过从大规模文档或数据库中检索相关信息,辅助生成模型以提升回答的准确性和相关性。其核心流程包括用户输入查询、系统检索相关知识、生成模

第2个文档 - 大小:100, 内容:相关性。其核心流程包括用户输入查询、系统检索相关知识、生成模型基于检索结果生成内容,并输出最终答案。RAG的优势在于能够弥补生成模型的知识盲区,提供更准确、实时和可解释的输出,广泛应用于问答系统、内容

第3个文档 - 大小:85, 内容:区,提供更准确、实时和可解释的输出,广泛应用于问答系统、内容生成、客服、教育和企业领域。然而,其也面临依赖高质量知识库、可能的响应延迟、较高的维护成本以及数据隐私等挑战。

拼接后文本大小:225
是否与原始文本完全一致:True
拼接后完整内容:
大模型RAG(检索增强生成)是一种结合生成模型与外部知识检索的技术,通过从大规模文档或数据库中检索相关信息,辅助生成模型以提升回答的准确性和相关性。其核心流程包括用户输入查询、系统检索相关知识、生成模型基于检索结果生成内容,并输出最终答案。RAG的优势在于能够弥补生成模型的知识盲区,提供更准确、实时和可解释的输出,广泛应用于问答系统、内容生成、客服、教育和企业领域。然而,其也面临依赖高质量知识库、可能的响应延迟、较高的维护成本以及数据隐私等挑战。
"""- 分割 Document 对象(先加载再分割)
【案例源码】案例与源码-2-LangChain框架/10-rag/textsplit/RecursiveDocumentSplitter.py
"""
【案例】对 Document 列表做分割:先加载再 split_documents

对应教程章节:第 11 章 - RAG 检索增强生成 → 2、RAG 文本处理核心知识

知识点速览:
- 实际 RAG 流程常是「加载器 load() → Document 列表 → 分割器 split_documents() → 更小的 Document 列表」。
- split_documents(documents):直接对 Document 列表切分,每个 Document 的 page_content 会被按 chunk_size/chunk_overlap 切块,切出的块仍带 metadata(可继承或按实现保留)。
- 这类写法最贴近真实 RAG 项目,因为它既保留了 loader 产出的 metadata,又完成了后续向量化之前最关键的切块步骤。
- 本示例用 UnstructuredLoader 加载 rag.txt,再用 RecursiveCharacterTextSplitter 切分;需 pip install python-magic-bin(部分环境)。
- 为何用 split_documents 而不是 split_text?split_text(字符串) 入参是「一段文本」,返回字符串列表;这里入参是 Document 列表(来自 loader.load()),需要得到「带 metadata 的 Document 列表」供后续向量化/检索,只能用 split_documents。
"""

from pathlib import Path

# pip install langchain-unstructured(部分环境加载本地文件还需 python-magic-bin)
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_unstructured import UnstructuredLoader

# 1. 加载文档得到 Document 列表
document_path = Path(__file__).resolve().with_name("rag.txt")
loader = UnstructuredLoader(document_path)
documents = loader.load()

# 2. 同一套分割参数:块 100 字符,重叠 30
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=100, chunk_overlap=30, length_function=len
)

# 3. 直接对 Document 列表分割,返回更小的 Document 列表(不能改用 split_text:入参是 Document 列表,且需保留 metadata)
splitter_documents = text_splitter.split_documents(documents)

print(f"分割文档数量:{len(splitter_documents)}")
for splitter_document in splitter_documents:
    print(f"文档片段:{splitter_document.page_content}")
    print(
        f"文档片段大小:{len(splitter_document.page_content)}, 文档元数据:{splitter_document.metadata}"
    )

"""
【输出示例】
分割文档数量:14
文档片段:《倚天屠龙记》是金庸“射雕三部曲”的终章,以元末乱世为背景,谱写了一曲江湖侠义与家国情怀交织的传奇。
文档片段大小:50, 文档元数据:{'source': 'rag.txt', 'last_modified': '2026-03-10T10:36:41', 'languages': ['zho'], 'filename': 'rag.txt', 'filetype': 'text/plain', 'category': 'Title', 'element_id': '2089ea66f6635c149a4ea8fda049b579'}
文档片段:小说核心围绕张无忌的成长轨迹展开,他本是武当弟子张翠山与天鹰教殷素素之子,自幼身中玄冥神掌,历经磨难却得奇遇,
文档片段大小:55, 文档元数据:{'source': 'rag.txt', 'last_modified': '2026-03-10T10:36:41', 'languages': ['zho'], 'filename': 'rag.txt', 'filetype': 'text/plain', 'category': 'Title', 'element_id': '391f965ee98ac9ace2fac0a7c04ce062'}
……
"""
这三个案例分别对应三种入口:
split_text():字符串 -> 字符串列表create_documents():字符串列表 ->Document列表split_documents():Document列表 -> 更小的Document列表
其中在真实 RAG 项目里,最常见的往往是最后一种,也就是:
loader.load() -> split_documents() -> embeddings -> vector store
2.4 进阶方向速览
入门管道跑通之后,真实项目里的优化通常会沿着下面几条线展开:
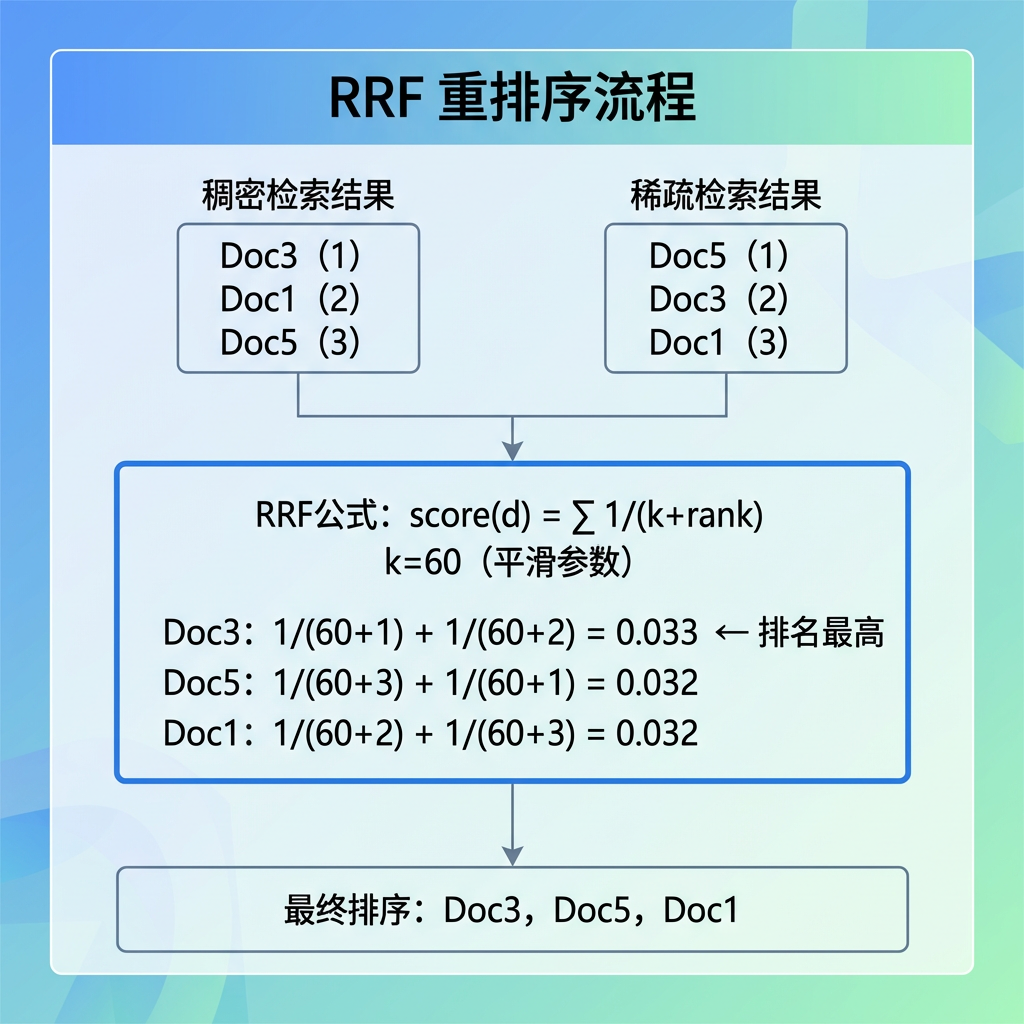
- 混合检索(Hybrid):关键词检索(如 BM25)与向量检索结合,缓解“专有名词、编号、错误码”等仅靠向量不够准的问题。
- 重排序(Rerank):先向量召回较多候选片段,再用交叉编码器等模型对「问题—片段」重新打分,提高最终送入 Prompt 的质量。
- 查询改写:多查询扩展、HyDE 等,用额外一步改善问句与文档的匹配(常与 Agent 或固定预处理脚本结合)。
- 评测与观测:准备一批「问题—期望引用片段或标准答」做回归;线上可用 LangSmith 等工具追踪检索与生成全链路,定位是检索差还是 Prompt / 模型问题。
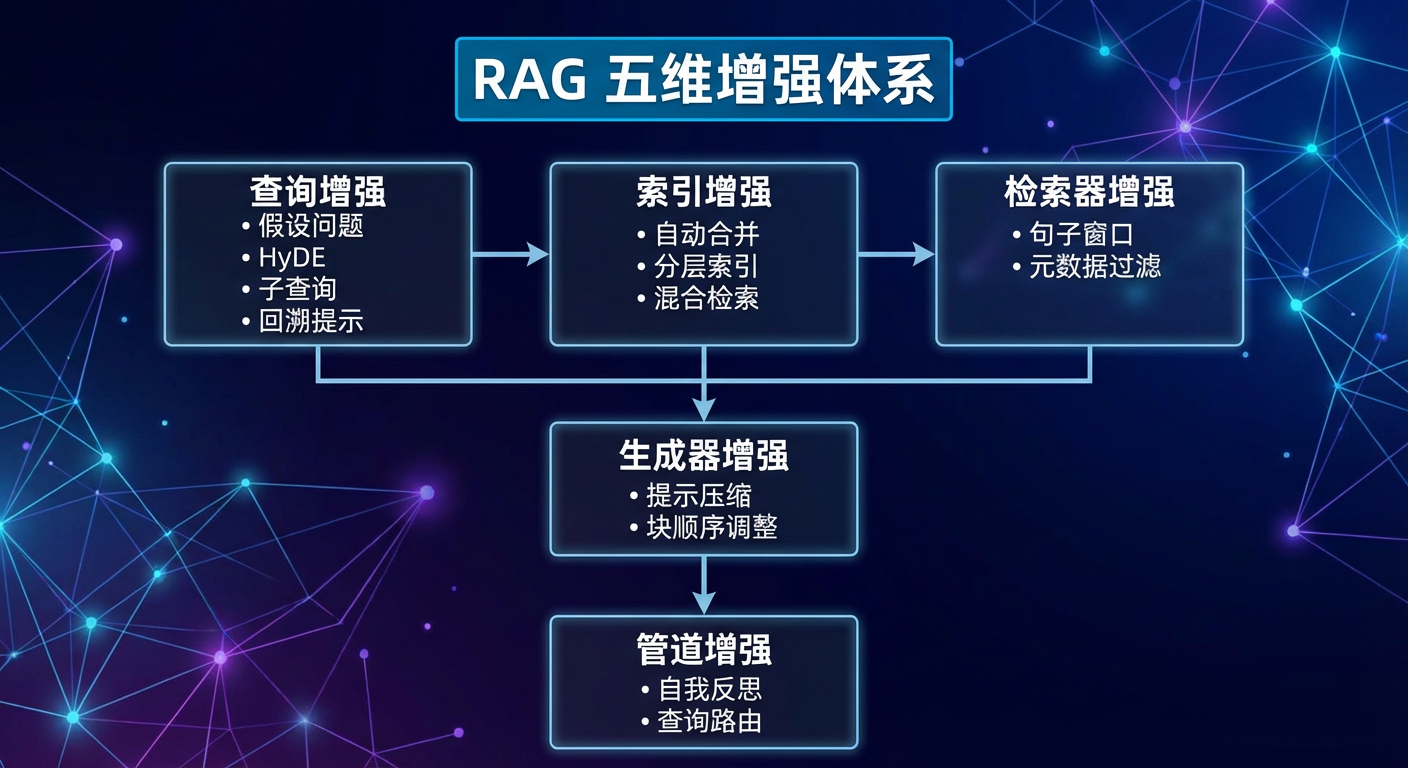
进一步看,生产级 RAG 的优化通常可以从五个方向入手:
| 方向 | 常见做法 | 主要解决什么 |
|---|---|---|
| 查询侧 | 查询改写、多查询、HyDE | 用户问法和文档说法对不上 |
| 索引侧 | 合理切块、Overlap、元数据、解析质量 | 入库内容太碎、太脏或缺少过滤字段 |
| 检索侧 | 向量检索、BM25、混合检索、RRF | 单一路径召回不稳定 |
| 排序侧 | Rerank、阈值过滤、Top K 调整 | 候选片段多但质量参差不齐 |
| 生成侧 | 引用来源、上下文压缩、答案约束 | 回答不可信或上下文太长 |
学习时先把 Redis 向量检索链路跑通;等项目规模变大,再考虑 Milvus 这类专业向量库里的 HNSW、BM25、Analyzer、标量过滤和混合检索能力。
这些主题与 第 13 章 Agent 智能体、后续 LangGraph 相关章节可以形成连续深入路线。
3、RAG 综合案例:智能运维助手
3.1 需求说明
本章综合案例的目标,不是做一个抽象的“百科问答”,而是做一个更贴近真实业务的场景:智能运维助手。
假设我们手里有一份错误码说明文档,例如 alibaba-java.docx,里面记录了各种错误码及含义。现在希望用户输入错误码后,系统能够:
- 理解用户的问题
- 去知识库里找到对应的错误码说明
- 基于检索到的内容生成可读答案
这类需求在真实项目里非常常见,因为:
- 企业内部的错误码通常是私有知识
- 文档会持续更新
- 不能指望通用大模型天然知道所有内部编码含义
所以它适合用 RAG 来做。
本案例的技术主线是:
- 文档来源:
alibaba-java.docx - 嵌入模型:阿里百炼向量模型
- 向量库:Redis / RedisStack
- 大模型:通义 / DeepSeek 等聊天模型
- 框架:LangChain
3.2 Before:未使用 RAG 的局限
如果不做 RAG,只是直接问模型:
00000 和 A0001 分别是什么意思?
模型可能出现几种情况:
- 根本不知道这些编码属于哪个系统
- 按通用语义胡乱猜测
- 给出似是而非、但无法核验的回答
这不是模型“笨”,而是因为这类知识通常不在它训练时稳定可得的公共语料里。也正因为如此,企业项目里很少把“私有知识问答”完全交给裸模型处理。
所以,真正的问题不是“模型会不会回答”,而是:它回答时有没有看到你自己的业务文档。
3.3 After:使用 RAG 的完整流程
【案例源码】案例与源码-2-LangChain框架/10-rag/EmbeddingRagLLM.py
"""
【案例】RAG 综合流程:加载 docx → 分割 → 向量化存 Redis → 检索 → 提示词模板 → 大模型回答

对应教程章节:第 11 章 - RAG 检索增强生成 → 3.3 After:使用 RAG 的完整流程

知识点速览:
- 这是一个完整的管道式 RAG 案例:同一份脚本里同时包含了索引阶段(加载、切分、向量化、入库)和检索生成阶段(检索、拼 Prompt、调 LLM)。
- 本例展示的是文档流驱动的入库路线:先通过 Loader 和 Splitter 得到 `Document` 列表,再用 `Redis.from_documents(...)` 一步完成向量化与建索引。
- 流程:文档加载(Docx2txtLoader)→ 分割(CharacterTextSplitter)→ 向量化并写入 Redis(from_documents)→ `as_retriever()` 得到检索器 → 用 LCEL 把 retriever、prompt、llm 串成链(context + question → prompt → llm)→ `invoke(question)` 得到答案。
- `RunnablePassthrough()` 表示「把输入原样传给下一环节」;这里把用户问题同时传给 retriever(作为查询)和 prompt(作为 `{question}`)。
- 本例刻意保留了“有 RAG / 无 RAG”的对比,便于直观看到:RAG 的价值不只是“能回答”,而是“回答时是否真的用到了外挂知识库”。
- 运行前需启动 Redis、配置 aliQwen-api,且 alibaba-java.docx 在可访问路径(如本脚本同目录)。
"""

# pip install unstructured docx2txt python-docx
import os
from pathlib import Path

from langchain.chat_models import init_chat_model
from langchain_community.document_loaders import Docx2txtLoader
from langchain_core.prompts import PromptTemplate
from langchain_classic.text_splitter import CharacterTextSplitter
from langchain_core.runnables import RunnablePassthrough
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_community.vectorstores import Redis
from dotenv import load_dotenv

load_dotenv()

# 大模型:用于最终根据「检索到的上下文 + 用户问题」生成回答
llm = init_chat_model(
    model="qwen-plus",
    model_provider="openai",
    api_key=os.getenv("aliQwen-api"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

# 提示词模板:{context} 由检索器填充,{question} 由用户输入填充;最终会生成一段字符串 Prompt 再交给聊天模型
prompt_template = """
    请使用以下提供的文本内容来回答问题。仅使用提供的文本信息,
    如果文本中没有相关信息,请回答"抱歉,提供的文本中没有这个信息"。

    文本内容:
    {context}

    问题:{question}

    回答:
    "
"""
prompt = PromptTemplate(
    template=prompt_template, input_variables=["context", "question"]
)

# 嵌入模型:用于文档与查询的向量化
embeddings = DashScopeEmbeddings(
    model="text-embedding-v3", dashscope_api_key=os.getenv("aliQwen-api")
)

# 1. 加载 docx(错误码文档)
document_path = Path(__file__).resolve().with_name("alibaba-java.docx")
loader = Docx2txtLoader(document_path)
documents = loader.load()

# 2. 分割(此处用 CharacterTextSplitter 便于快速跑通;真实项目里更常见的通用首选是 RecursiveCharacterTextSplitter)
text_splitter = CharacterTextSplitter(
    chunk_size=1000, chunk_overlap=0, length_function=len
)
texts = text_splitter.split_documents(documents)

print(f"文档个数:{len(texts)}")

# 3. 向量化并写入 Redis,建立索引(必须用分割后的 texts,否则整篇文档作为一块)
vector_store = Redis.from_documents(
    documents=texts,
    embedding=embeddings,
    redis_url="redis://localhost:26379",
    index_name="my_index3",
)

# 4. 检索器:按相似度取前 k 条作为 context
retriever = vector_store.as_retriever(search_kwargs={"k": 2})

# 5. LCEL 链:输入 question → context 由 retriever 查得,question 直通 → 拼 prompt → 调 llm
rag_chain = {"context": retriever, "question": RunnablePassthrough()} | prompt | llm

# 6. 提问并打印答案(有 RAG:从知识库检索);未接输出解析器时,聊天模型返回的是 AIMessage,正文通常通过 .content 读取
question = "00000和A0001分别是什么意思"
result = rag_chain.invoke(question)
print("\n=== 有外挂知识库(RAG:从 alibaba-java.docx 检索)===")
print("问题:", question)
print("回答:", result.content)

# 7. 对比演示:同一问题但「无外挂知识库」(context 为空,不查向量库,模拟未挂载文档)
no_rag_chain = (
    {
        "context": lambda _: "(未提供相关文档,模拟无外挂知识库)",
        "question": RunnablePassthrough(),
    }
    | prompt
    | llm
)
result_no_rag = no_rag_chain.invoke(question)
print("\n=== 无外挂知识库(模拟:不检索,仅靠模型自身知识)===")
print("问题:", question)
print("回答:", result_no_rag.content)

"""
【输出示例】
文档个数:1
"""

# === 有外挂知识库(RAG:从 alibaba-java.docx 检索)===
# 问题: 00000和A0001分别是什么意思
# 回答: 00000 的意思是“一切 ok”,表示正确执行后的返回;
# A0001 的意思是“用户端错误”,属于一级宏观错误码。

# === 无外挂知识库(模拟:不检索,仅靠模型自身知识)===
# 问题: 00000和A0001分别是什么意思
# 回答: 抱歉,提供的文本中没有这个信息
这个综合案例,基本把本章前面讲过的内容都串起来了。它的实际流程是:
- 用
Docx2txtLoader加载alibaba-java.docx - 用
CharacterTextSplitter把文档切成块 - 用
DashScopeEmbeddings把片段向量化 - 用 Redis 向量库 存储这些片段
- 用
as_retriever()生成检索器 - 用
PromptTemplate组织context + question - 用 聊天模型 基于检索结果生成最终答案
其中最值得注意的一行是:
rag_chain = {"context": retriever, "question": RunnablePassthrough()} | prompt | llm上面这一行用的是 第 7 章 LCEL 与链式调用 里的 LCEL 管道写法:把字典、RunnablePassthrough、Prompt 与 LLM 用 | 串成可执行链。它几乎就是“管道式 RAG”的缩影:
retriever根据用户问题去查知识库,产出contextRunnablePassthrough()把原始问题继续往后传prompt把context + question组装成提示词llm读取提示词并生成答案
3.3.1 贴近真实项目的原因
这个案例虽然规模不大,但已经具备了真实 RAG 项目的几个关键特征:
- 知识来自业务文档,而不是写死在 Prompt 里
- 知识先入库,再在问答时动态检索
- 回答依赖上下文,不再完全依赖模型记忆
- 同一个问题,可以对比“有知识库”和“无知识库”的差异
这正是很多企业项目的第一阶段形态:先做一个“能用、可验证、可扩展”的 RAG 原型,再逐步优化:
- 切块策略
- 检索条数
k - Prompt 约束方式
- 来源展示
- 召回重排
- 多轮对话结合记忆
3.3.2 本案例还有哪些值得你注意
综合案例用的是
CharacterTextSplitter
这能帮助你快速跑通流程;但在通用文本场景里,实际项目中更常见的首选仍然是RecursiveCharacterTextSplitter。Prompt 里明确写了“如果文本中没有相关信息,请直接说明”
这是 RAG 里常见的约束写法。因为检索不是百分百准确,Prompt 应该引导模型“基于上下文回答”,而不是脱离上下文自行发挥。脚本做了“有 RAG / 无 RAG”的对比演示
这一点适合教学,也适合项目早期验证价值。只有做对比,你才更容易判断:问题究竟出在模型本身,还是出在检索链路。Redis 只是这个案例里的向量存储后端
RAG 的本质不是绑定 Redis,而是“检索增强生成”这条流程。以后你换成 Chroma、FAISS、Milvus、PgVector,整体思路并不会变。
章节思考题:
一个完整 RAG 系统里,哪些步骤属于离线建库,哪些属于在线问答?
参考思路: 离线建库包括文档加载、清洗、切分、Embedding、入向量库;在线问答包括问题向量化、召回、重排、上下文组装、模型生成和答案返回。两段分清,排障会简单很多。
文本切分为什么不是越细越好,也不是越大越好?
参考思路: 太细会丢上下文,太大又会引入噪声并浪费 token。好的切分要兼顾语义完整、召回精度和上下文成本,必要时还要保留标题、层级和来源信息。
如果 RAG 答案出现幻觉,你会如何判断是检索问题还是生成问题?
参考思路: 先看召回片段是否包含答案依据。如果没召回到,查文档、切分、Embedding 和检索参数;如果召回到了但模型乱答,查 Prompt、引用约束、上下文排序和输出要求。
为什么 RAG 需要保留来源和 metadata?
参考思路: 来源能让答案可追溯,metadata 能支持过滤、排序、权限控制和排障。企业场景里,只答对还不够,还要知道依据来自哪里、是否有权限使用。
本章小结:
- RAG 的本质:不是训练模型,而是先检索外部知识,再让模型基于知识生成答案。
- RAG 的两阶段:索引阶段负责“准备知识库”,检索阶段负责“每次提问时动态查资料”(与官方文档中的 2-Step RAG 一致)。
- 本章的新增重点:相比 第 10 章,这一章补上了“文档从哪来、如何切块、如何把检索结果喂给模型”。
- 本章案例主线:从多格式文档加载,到文本切分,再到 Redis 检索和智能运维助手,构成完整的入门版 RAG 系统;但真正上线时,效果还取决于文档质量、切块策略、召回、重排、Prompt 约束和评估闭环是否做扎实。
- 学完本章后,你应当能够:用“索引阶段”和“检索与生成阶段”两段式描述 RAG 的标准流程;知道文档加载器、文本分割器、Embedding、向量库、检索器、Prompt、聊天模型在 RAG 中各自负责哪一步;区分 管道式 RAG 和 Agent 式 RAG 的差别,并理解 RAG 质量由“文档、检索、生成、评估”共同决定。
建议下一步: 先把本章的文档加载、文本切分、综合案例至少各跑通一个,再回头对照 第 10 章 向量数据库与 Embedding 实战,把“向量化 → 入库 → 检索”这条底层链路重新连一遍;如果你准备继续学习“什么时候固定写死检索流程,什么时候让系统自己决定是否检索”,就顺势进入 第 13 章 Agent 智能体。