项目的技术架构
| 层 | 技术 |
|---|---|
| Web 框架 | FastAPI |
| AI 编排 | LangGraph(状态图)+ LangChain(模型/工具/消息) |
| 大模型 | DeepSeek(通过 OpenAI 兼容接口)+ Ollama/阿里百炼 |
| 向量数据库 | Milvus 2.6 |
| 关系数据库 | PostgreSQL 16 |
| 前端 | React + Ant Design |
| 包管理 | uv |
| 部署 | Docker Compose |
Python后端项目依赖
pyproject.toml文件,内容如下:
[project]
name = "agent-service"
version = "0.1.0"
description = "Insurance AI agent service"
requires-python = ">=3.14"
dependencies = [
    "aiostream>=0.7.1",
    "asyncpg>=0.31.0",
    "beautifulsoup4>=4.15.0",
    "dashscope>=1.26.4",
    "fastapi>=0.139.2",
    "ipykernel>=7.3.0",
    "langchain>=1.3.14",
    "langchain-community>=0.4.2",
    "langchain-deepseek>=1.1.0",
    "langchain-mcp-adapters>=0.3.0",
    "langchain-milvus>=0.4.0",
    "langchain-ollama>=1.1.0",
    "langchain-text-splitters>=1.1.2",
    "langgraph-checkpoint-postgres>=3.1.0",
    "mineru-open-sdk>=0.2.5",
    "openai>=2.48.0",
    "psycopg[binary,pool]>=3.3.4",
    "pwdlib[argon2]>=0.3.0",
    "pydantic>=2.13.4",
    "pydantic-settings>=2.14.2",
    "pyjwt>=2.13.0",
    "pymilvus>=3.0.0",
    "pypdf>=6.14.2",
    "sqlalchemy>=2.0.51",
    "structlog>=26.1.0",
    "uvicorn>=0.51.0",
]


[[tool.uv.index]]
url = "https://pypi.tuna.tsinghua.edu.cn/simple"
default = true
项目的代码结构
在实际项目开发中,业务会很复杂,业务领域也很多,为了方便管理,项目必须按照职责严格划分不同的包和模块。而项目的职责主要可以分为:
- core:核心模块
- infra:基础设施模块
- common:通用模块
- modules:业务模块,主要是实现数据库的CRUD以及与前端对接。
准备工作
1.环境变量与配置管理
安装项目的依赖:
uv add pydantic-settings在项目的根目录创建.env文件,内容参考如下:
# 应用配置
APP_NAME=安心保
APP_DEBUG=true
APP_HOST=0.0.0.0
APP_PORT=8001

# 日志配置
LOGGING_LEVEL=INFO

# 数据库配置
DB_HOST=192.168.150.101
DB_PORT=5432
DB_NAME=insurance
DB_USER=insurance
DB_PASSWORD=insurance123

# 模型配置
DEEPSEEK_API_KEY=your_deepseek_api_key
CHAT_MODEL=deepseek-v4-flash配置加载:在app.core包新建一个config.py文件:
from pathlib import Path

from pydantic import Field, computed_field, PostgresDsn
from pydantic_settings import BaseSettings, SettingsConfigDict

# 以当前文件为基准,找向上2级的父目录,也就是项目的根目录
APP_ROOT = Path(__file__).resolve().parents[2]

class EnvSettings(BaseSettings):
    """公共settings,配置.env文件位置"""
    model_config = SettingsConfigDict(
        env_file=(APP_ROOT / ".env",),
        env_file_encoding="utf-8",
        extra="ignore",  # settings中未定义的字段被忽略
    )

class AppSettings(EnvSettings):
    """应用相关设置"""
    name: str = Field(alias="APP_NAME")
    host: str = Field(alias="APP_HOST", default="127.0.0.1")
    port: int = Field(alias="APP_PORT", default=8001)
    debug: bool = Field(alias="APP_DEBUG", default=True, description="是否开启FastAPI的DEBUG模式")

class DatabaseSettings(EnvSettings):
    """数据库相关设置"""
    host: str = Field(alias="DB_HOST", default="localhost")
    port: int = Field(alias="DB_PORT", default=5432)
    name: str = Field(alias="DB_NAME", default="insurance")
    user: str = Field(alias="DB_USER", default="insurance")
    password: str = Field(alias="DB_PASSWORD", default="insurance123")

    @computed_field
    @property
    def url(self) -> str:
        # 自动拼接URL路径
        return PostgresDsn.build(
            scheme="postgresql+asyncpg",
            host=self.host,
            port=self.port,
            username=self.user,
            password=self.password
        ).encoded_string()

class LLMSettings(EnvSettings):
    """模型相关配置"""
    api_key: str = Field(alias="DEEPSEEK_API_KEY")
    chat_model: str = Field(alias="CHAT_MODEL", default="deepseek-v4-flash")

class LoggingSettings(EnvSettings):
    """日志相关配置"""
    level: str = Field(alias="LOGGING_LEVEL", default="INFO") # 可选值:DEBUG、INFO、WARNING、ERROR、CRITICAL

class Settings(BaseSettings):
    app: AppSettings = Field(default_factory=AppSettings)
    db: DatabaseSettings = Field(default_factory=DatabaseSettings)
    llm: LLMSettings = Field(default_factory=LLMSettings)
    logging: LoggingSettings = Field(default_factory=LoggingSettings)

# 项目启动直接初始化
settings = Settings()
2.日志模块
项目中日志需要统一配置,我们在app.core包下单独定义一个处理日志的文件logging.py:
from __future__ import annotations

import logging
import sys
from typing import Any

import structlog


def configure_logging(level: str = "INFO") -> None:
    """配置彩色控制台日志。"""

    log_level = _log_level(level)

    # 配置 Python 标准 logging
    root_logger = logging.getLogger()
    root_logger.setLevel(log_level)
    root_logger.handlers.clear()

    console_handler = logging.StreamHandler(sys.stdout)
    console_handler.setLevel(log_level)
    console_handler.setFormatter(
        logging.Formatter("%(message)s")
    )

    root_logger.addHandler(console_handler)

    # 配置 structlog
    processors: list[Any] = [
        # 合并 request_id、conversation_id 等上下文变量
        structlog.contextvars.merge_contextvars,
        # 添加 Logger 名称
        structlog.stdlib.add_logger_name,
        # 添加日志级别
        structlog.stdlib.add_log_level,
        # 添加时间
        structlog.processors.TimeStamper(fmt="%Y-%m-%d %H:%M:%S", utc=False),
        # 允许添加占位符参数
        structlog.stdlib.PositionalArgumentsFormatter(),
        # 渲染 stack_info=True
        structlog.processors.StackInfoRenderer(),
        # 渲染异常堆栈
        structlog.processors.format_exc_info,
        # 彩色控制台渲染
        structlog.dev.ConsoleRenderer(colors=True),
    ]

    structlog.configure(
        processors=processors,
        wrapper_class=structlog.stdlib.BoundLogger,
        logger_factory=structlog.stdlib.LoggerFactory(),
        cache_logger_on_first_use=True,
    )

    # 控制第三方库日志数量
    logging.getLogger("sqlalchemy.engine").setLevel(
        logging.INFO
        if log_level == logging.DEBUG
        else logging.WARNING
    )

    logging.getLogger("httpx").setLevel(logging.WARNING)
    logging.getLogger("httpcore").setLevel(logging.WARNING)


def get_logger(name: str) -> structlog.stdlib.BoundLogger:
    """获取 structlog 日志器。"""
    return structlog.get_logger(name)

def _log_level(level: str) -> int:
    """将字符串日志级别转换为 logging 常量。"""
    return getattr(logging, level.strip().upper(), logging.INFO)
启动模块:在初始化FastApi和项目启动的入口:
from fastapi import FastAPI
from fastapi.middleware.cors import CORSMiddleware

from app.core.config import settings
from app.core.logging import configure_logging, get_logger
import uvicorn

# 初始化日志系统
configure_logging(settings.logging.level)
logger = get_logger(__name__)

app = FastAPI(
    title=settings.app.name,
    debug=settings.app.debug,
)

# CORS配置,解决跨域问题
app.add_middleware(
    CORSMiddleware,
    allow_origins=["http://localhost:5173", "http://127.0.0.1:5173"],
    allow_credentials=True,
    allow_methods=["*"],
    allow_headers=["*"],
)

@app.get("/health", summary="健康检测接口")
async def health_check() -> dict[str, str]:
    logger.info("执行健康检查")
    return {"status": "ok"}


if __name__ == "__main__":
    uvicorn.run(
        "app.main:app",
        host=settings.app.host,
        port=settings.app.port,
        reload=False
    )
3.数据库连接池
使用SqlAchemy创建引擎的时候,虽然数据库连接池已经有了一些默认参数,我们仍然可以根据业务需要自定义最大线程数、临时线程数等一些配置。
可以在app.core.config.py中添加数据库连接池相关参数。然后新建一个database.py文件,新增的代码内容如下:
class DatabaseSettings(EnvSettings):
    """数据库相关设置"""
    host: str = Field(alias="DB_HOST", default="localhost")
    port: int = Field(alias="DB_PORT", default=5432)
    name: str = Field(alias="DB_NAME", default="insurance")
    user: str = Field(alias="DB_USER", default="insurance")
    password: str = Field(alias="DB_PASSWORD", default="insurance123")
    echo: bool = Field(alias="DB_ECHO", default=False)
    pool_size: int = Field(alias="DB_POOL_SIZE", default=5)
    max_overflow: int = Field(alias="DB_MAX_OVERFLOW", default=10)
    pool_recycle: int = Field(alias="DB_POOL_RECYCLE", default=1800)

    @computed_field
    @property
    def url(self) -> str:
        # 自动拼接URL路径
        return PostgresDsn.build(
            scheme="postgresql+asyncpg",
            host=self.host,
            port=self.port,
            username=self.user,
            password=self.password
        ).encoded_string()
在这儿,有一个url方法,我们给这个方法增加了两个装饰器:
@property:代表函数可以作为属性使用@computed_filed:代表这是一个需要动态计算的属性,在按照属性的方式调用这个这个函数的时候,会动态的计算,以返回值作为属性值
那以后创建引擎的时候,可以直接通过settings.db.url,直接拿到计算完成的数据库连接地址了,省去了很多麻烦。
3.1.统一管理连接池
经过上面的步骤,我们连接数据库所需要的参数都已经准备好了,那接下来就可以去创建引擎了,或者叫做创建数据库连接池。
在项目中,数据库连接池需要统一管理,然后通过依赖注入方式给每个用户请求分发连接,连接断开后自动释放连接,那我们需要做的就是这么几件事:
- 引擎层
- 创建异步数据库引擎
- 提供初始化数据库的方法
- 提供销毁引擎的方法
- 会话层
- 创建异步session管理器
- 提供获取session的工具
新建一个app.infra包,存放基础设施模块。然后在app.infra文件夹中创建一个database.py的文件,用来管理数据库的基础操作。
# 目标:连接关系型数据库
from sqlalchemy import text
from sqlalchemy.ext.asyncio import create_async_engine, async_sessionmaker

from app.core.config import settings
from app.core.logging import get_logger

logger = get_logger(__name__)

# 1.引擎层相关代码
# 1.1 创建引擎(异步)
engine = create_async_engine(
    settings.db.url,
    # 是否打印SQL日志
    echo = settings.db.echo,
    # 核心连接数
    pool_size = settings.db.pool_size,
    # 临时最大连接数
    max_overflow = settings.db.max_overflow,
    # 防止连接超时的一个时间
    pool_recycle = settings.db.pool_recycle
)
# 1.2 初始化数据库连接方法
async def check_database():
    async with engine.connect() as connection:
        await connection.execute(text("SELECT 1"))
    logger.info("数据库连接初始化完成~")

# 1.3 销毁引擎
async def close_database():
    await engine.dispose()
    logger.info("数据库引擎销毁完成~")

# 2.会话层相关代码
# 2.1 根据引擎创建会话工厂
AsyncSessionFactory = async_sessionmaker(
    bind=engine,
    autoflush=False,
    expire_on_commit=False
)
# 2.2 提供一个获取具体的一个的会话的工具
async def get_session():
    async with AsyncSessionFactory() as session:
        yield session
在这儿,具体解释一下上述代码:
- 数据库初始化*:默认情况下,数据库连接不能立刻使用,而是要在第一次执行操作的时候才会初始化,所以我们在这儿先*将所有的连接激活
- 异步 Session 工厂*,需要修改2个默认参数值*
- 关闭autoflush,默认为True,同一会话中,会先执行提交操作再查询,如果有一些对象还没有构造完成,就会往数据库中写入半成品。
- 关闭expire_on_commit,默认为True,提交之后,已提交的对象属性过期,如果再去获取属性值,需要再去数据库里面重新查询出来,效率低的同时,有可能查询到不一致的数据。
- 获取session的工具,就不需要像AI智能伴侣系统那么复杂了,有两个原因:
- 使用**async with(异步上下文管理器)来创建session,会自动的执行session.close()**关闭session
- 捕获了异常也是使用raise上报到全局异常处理器,索性不捕获了,交由业务层自行处理异常。
3.2.生命周期管理
方法已经定义好了,剩下的就是在main.py中,基于FastAPI的生命周期管理来实现了。
- 在项目启动时,调用调用
check_database初始化数据库连接池 - 在项目停止时,调用
close_db销毁数据库连接池
修改app.main.py**文件,添加生命周期管理函数。**代码参考如下:
from contextlib import asynccontextmanager

@asynccontextmanager
async def lifespan(app:FastAPI):
    """
    生命周期管理函数
    :param app: FastAPI实例
    """
    # 1.FastAPI刚刚启动的时候执行的代码逻辑
    # 1.1 导入check_database和close_database,加载database模块
    from app.infra.database import check_database, close_database
    # 1.2 执行数据库连接的初始化操作
    await check_database()
    logger.info("数据库连接初始化完成~")
    yield
    # 2.项目关闭的时候执行的一些代码逻辑
    # 2.1 执行数据库连接的关闭操作
    await close_database()
    logger.info("数据库连接关闭完成~")

app = FastAPI(
    title=settings.app.name,
    debug=settings.app.debug,
    lifespan=lifespan
)
业务开发参考
按照之前的项目结构说明,业务功能要放到app.modules包,并且给不同的业务创建子包,例如产品相关业务,就创建一个product包,一般来说,在这样一个业务模块内,我们会创建router.py、service.py、models.py、repository.py、schemas.py这五个文件。模块之间的关系如下:
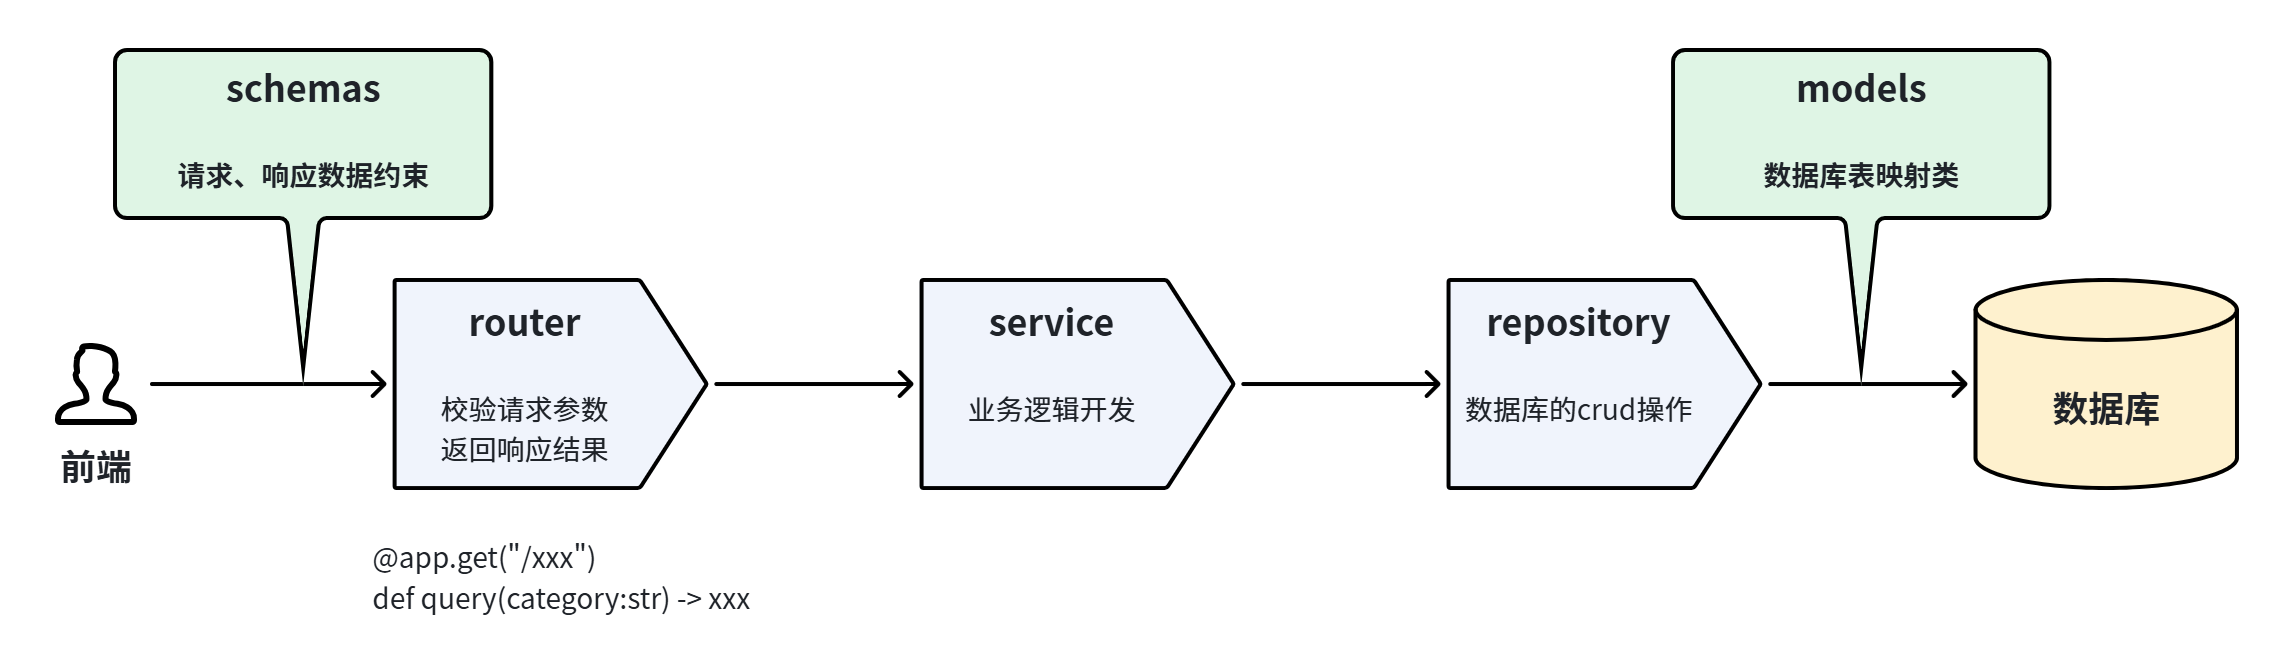
如图中所示:
router、service、repository之间是依赖关系,router依赖于service,service依赖于repository。schemas是按照接口文档规范定义的请求和响应约束模型,models是数据库表映射类,这两类数据在各层间传递,需要先定义出来。- 开发业务时从底层的
repository开始,逐层向上开发。
重要提示
以下我们均以product产品模块为案例进行讲解。
Schemas
提示
schemas就是接口的请求参数和响应结果约束,严格按照接口文档要求定义即可。
新建一个app.modules.product包,在其中新建一个schemas.py文件。
from decimal import Decimal
from pydantic import BaseModel, field_validator


class ProductResponse(BaseModel):
    """保险产品响应结果"""

    id: int
    name: str
    clause_name: str
    category: str
    insurer: str
    image_url: str
    description: str
    min_premium: Decimal | None
    max_premium: Decimal | None
    target_group: str | None
    highlights: list[str]
    status: str
Schemas补充
使用Field,加强对数据的校验,它是一个函数,里面有许多参数,比如:
- default:设置默认值
- gt:判断是否大于设置的参数
- ge:判断是否大于等于设置的参数
- lt:判断是否小于设置的参数
- le:判断是否小于等于设置的参数
- min_length:判断是否超过设置的最小长度
- max_length:判断是否不超过设置的最大长度
现在对数据的校验解决了,那我们想对前端发送过来的数据做一些前置和后置的处理怎么办?比如:去除两端空白字符
校验器就可以派上用场了,校验器是BaseModel模型中的一个普通方法,函数体就是对某一项数据的处理策略。
然后对这个方法增加两个装饰器就可以了。
@classmethod:固定语法@field_validator("title", mode="before"):属性绑定- 第一个位置参数,填写要绑定的属性
- 第二个关键字参数,填写处理时机
mode="before",代表在默认的校验之前执行mode="after",代表在默认的校验之后执行
案例参考:
- 创建会话时可以不传
title,默认使用“新会话” - 最小长度1
- 最大长度200
现在就可以使用校验器先对前端的数据进行预处理,再使用Filed对进行长度的校验了。
from datetime import datetime
from uuid import UUID

from pydantic import BaseModel, Field, field_validator


class ChatThreadCreate(BaseModel):
    """创建会话请求"""

    title: str = Field(default="新会话", min_length=1, max_length=200)

    # 这里需要特别注意的是写的顺序必须按照这里的代码顺序,写反了就会报错
    @field_validator("title", mode="before")
    @classmethod
    def normalize_title(cls, value: str) -> str:
        return value.strip()


class ChatThreadResponse(BaseModel):
    """会话响应"""

    id: UUID
    title: str
    created_at: datetime
    updated_at: datetime
Models
提示
如前所述Schema 负责约束接口数据,Model 则负责描述数据库表。
- 基类:也就是Base类,标记当前类是SqlAlchemy的表相关实体类,不仅仅是Product业务需要,以后的其它业务模型都需要,所以属于公共父类,放到
app.common包。 - 混入类:就是提取一些表公共字段,其它表模型类继承了混入类,就省去了对应字段的编写,提高复用性。
新建一个app.common包,在这个包中新建一个models.py的文件:
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column
from datetime import datetime
from sqlalchemy import DateTime, func

# SQLAlchemy的基类,所有数据库表模型都必须继承
class Base(DeclarativeBase):
    def __repr__(self) -> str:
        """通用的repr函数,用于控制台输出对象信息"""
        cls_name = self.__class__.__name__
        attrs = {}
        for key, val in vars(self).items():
            if key.startswith("_"):
                continue
            if isinstance(val, datetime):
                attrs[key] = val.strftime("%Y-%m-%d %H:%M:%S")
            else:
                attrs[key] = val
        return f"{cls_name}({attrs})"

# 通用的时间戳【混入类】,这样其它数据模型不用重复定义时间相关字段
class CreateAtMixin:
    # func.now() 会让数据库在插入时自动生成服务器时间(如 PostgreSQL 的 NOW())
    created_at: Mapped[datetime] = mapped_column(
        DateTime(timezone=True),
        server_default=func.now()
    )

class UpdateAtMixin:
    # onupdate=func.now() 会在每次数据行被 UPDATE 时,由 SQLAlchemy 自动更新该字段
    updated_at: Mapped[datetime] = mapped_column(
        DateTime(timezone=True),
        server_default=func.now(),
        onupdate=func.now()
)上面描述的是一个项目的基类和混入类,但是在实际的开发中,我们还需要根据数据库表在业务模块中新建对应的model文件,我们先看一份参考的products表:
CREATE TABLE "products" (
        "id" SERIAL NOT NULL,
        "name" VARCHAR(200) NOT NULL,
        "clause_name" VARCHAR(300) NOT NULL,
        "category" VARCHAR(50) NOT NULL,
        "insurer" VARCHAR(120) NOT NULL,
        "image_url" TEXT NULL DEFAULT NULL,
        "description" TEXT NULL DEFAULT NULL,
        "min_premium" NUMERIC(14,2) NULL DEFAULT NULL,
        "max_premium" NUMERIC(14,2) NULL DEFAULT NULL,
        "target_group" VARCHAR(300) NULL DEFAULT NULL,
        "highlights" UNKNOWN NULL DEFAULT NULL,
        "status" VARCHAR(30) NOT NULL DEFAULT 'active',
        "created_at" TIMESTAMPTZ NOT NULL DEFAULT CURRENT_TIMESTAMP,
        "updated_at" TIMESTAMPTZ NOT NULL DEFAULT CURRENT_TIMESTAMP,
        PRIMARY KEY ("id")
)
接下来,我们只需要参考表结构定义model即可。
既然是products表,我们定义模型的名称为Product,需要注意以下几点:
Product需要继承CreateAtMixin和UpdateAtMixin,因此这里不需要重复声明created_at和updated_at了- 金额字段在数据库中是
NUMERIC(14, 2),Model 使用Decimal可以避免浮点误差。
具体代码实现如下(当然,有一点我们需要注意的是,这些Model数据不建议一个一个手搓实现,可以借助AI工具帮我们提高开发的效率):
from decimal import Decimal

from sqlalchemy import ARRAY, BigInteger, Numeric, String, Text
from sqlalchemy.orm import Mapped, mapped_column

from app.common.models import Base, CreateAtMixin, UpdateAtMixin


class Product(Base, CreateAtMixin, UpdateAtMixin):
    """保险产品"""

    __tablename__ = "products"

    id: Mapped[int] = mapped_column(BigInteger, primary_key=True)
    name: Mapped[str] = mapped_column(String(200))
    clause_name: Mapped[str] = mapped_column(String(300))
    category: Mapped[str] = mapped_column(String(50))
    insurer: Mapped[str] = mapped_column(String(120))
    image_url: Mapped[str | None] = mapped_column(Text)
    description: Mapped[str | None] = mapped_column(Text)
    min_premium: Mapped[Decimal | None] = mapped_column(Numeric(14, 2))
    max_premium: Mapped[Decimal | None] = mapped_column(Numeric(14, 2))
    target_group: Mapped[str | None] = mapped_column(String(300))
    highlights: Mapped[list[str] | None] = mapped_column(ARRAY(Text))
    status: Mapped[str] = mapped_column(
        String(30),
        default="active",
        server_default="active",
    )
Repository
提示
Repository 只负责数据库访问,不处理接口参数,也不组装响应对象。
在 app.modules.product 包中新建 repository.py。
那我们现在要查询表中的数据,就应该是ProductRepository中的一个功能,也就是一个方法了,既然按照分类进行查询,可以叫做:find_by_category
实现这个方法也比较简单,只需要执行一条 SQL:根据可选的产品分类组装过滤条件,然后按产品 ID 升序返回全部符合条件的数据。
接口仅展示有效产品,因此默认应该增加 status == "active" 条件。
现在是在操作数据库?是否需要session的参与?
肯定需要,而类中的方法不能直接执行,必须创建对象之后才能调用,那我们就可以在创建这个对象的时候,交由对象的使用者给我传递一个session就可以了,那session就是一个属性了。
经过上面的分析,我们的代码就可以写出来了。
from sqlalchemy import select
from sqlalchemy.ext.asyncio import AsyncSession

from app.modules.product.models import Product


class ProductRepository:
    def __init__(self, session: AsyncSession):
        self.session = session

    async def find_by_category(
        self,
        category: str | None = None,
    ) -> list[Product]:
        # select * from products where status = 'active' order by id;
        # select * from products where status = 'active' and category = category order by id;

        # 1.组装查询条件
        # 1.1.默认只查询active状态的产品
        conditions = [Product.status == "active"]
        # 1.2.如果有category,则添加category过滤
        if category:
            conditions.append(Product.category == category)

        # 2.准备SQL
        sql = select(Product).where(*conditions).order_by(Product.id.asc())

        # 3.执行
        select_execute_result = await self.session.execute(sql)

        # 4.获取数据
        product_list = select_execute_result.scalars().all()

        # 5.返回数据
        return product_list
Service
提示
Service 负责组织业务流程:开启事务(如果有必要的话)、调用 Repository,并把数据库 Model 转换为接口 Schema(如果有必要的话)。
同样的,业务层也使用类来组织业务逻辑。
在这儿,我们的业务比较简单,要做2件事:
- 要调用Repository中的方法,就要准备好对应的对象,而这儿对象并不只是使用一次,所以应该定义为类中的一个属性,就可以多次使用了。
- 另外,service层也不做session的创建,而repository层需要,所以需要router在创建业务层对象的时候传递进来。
- 只需要定义一个方法,调用Repository中刚刚写好的find_by_category方法就可以了。
from sqlalchemy.ext.asyncio import AsyncSession

from app.modules.product.repository import ProductRepository
from app.modules.product.schemas import ProductResponse


class ProductService:
    def __init__(self, session: AsyncSession):
        self.session = session
        self.repository = ProductRepository(session)

    async def list_products(
        self,
        category: str | None = None,
    ) -> list[Product]:
        return await self.repository.find_by_category(category)
Service补充
一直在强调,在Repository层,我们没有进行提交操作,目的就是在Service层统一进行事务的管理,怎么管理?
首先,考虑大家最熟悉的写法,不出意外,代码应该是这样的。
session = Session()

try:
    user = User(name="张三")
    session.add(user)
    session.commit()         # 成功,提交
except Exception:
    session.rollback()       # 失败,回滚
    raise
finally:
    session.close()          # 不管成没成,都得关连接
能不能优化一下?
这里面有一个非常典型的资源关闭的代码:session.close(),以后大家遇到需要资源关闭的场景都可以考虑使用上下文管理器,那优化一下,代码应该是这样的。
with Session() as session:
    user = User(name="张三")
    session.add(user)
你可能会问,你的提交和回滚呢?不需要了,退出 with 的时候,Session 会自动判断。
- 正常走完**:** 自动
commit - 中途抛异常 :自动
rollback
现在,是不是很清爽了,只需要关注业务代码就可以了,其余的固定范式都交由上下文管理器来处理。
不过在我们FastAPI场景中,Session()的创建不由我们控制,而是别人传递给我们的,那怎么开启事务呢?
不麻烦,只需要使用session.begin(),就可以开启事务了,代码应该是这样的。
# 异步Session的话,也只需要修改为异步上下文管理器
with session.begin():
    user = User(name="张三")
    session.add(user)
具体的代码参考:
from sqlalchemy.ext.asyncio import AsyncSession

from .repository import ChatThreadRepository
from .models import ChatThread

class ChatThreadService:

    def __init__(self, session: AsyncSession):
        self.session = session
        self.repository = ChatThreadRepository(session)

    async def add(self, user_id: int , title: str):
        # 1.用上下文管理,开启事务,运行完成,自动commit,出现异常,自动rollback
        async with self.session.begin():
            # 2.创建对象,对象 映射 到数据库 一条数据
            chat_thread = ChatThread(user_id = user_id, title = title)
            # 3.调用Repository中的方法新增对象,也就是插入一条数据
            await self.repository.add(chat_thread)
            # 4.返回前端需要的数据
            return chat_thread
特别注意
在sqlarchemy中,除了查询操作不需要开启事务之外,其他的操作都需要开启事务,请牢记。
Router
注意
Router 只负责 HTTP 层:声明路径、接收并校验查询参数、注入数据库会话,然后把请求交给 Service。
在 app.modules.product 包中新建 router.py模块。
根据查询产品列表的接口文档,我们已经分析出来了请求格式和响应格式,一步步的来编写接口就可以了
- 准备APIRouter实例对象
- 根据请求格式编写装饰器
- 定义函数,接受category参数
- 基于依赖注入创建session
- 实现函数体
- 创建业务层对象
- 调用其方法返回前端数据
from fastapi import APIRouter, Depends
from sqlalchemy.ext.asyncio import AsyncSession

from app.infra.database import get_session
from app.modules.product.schemas import ProductResponse
from app.modules.product.service import ProductService

router = APIRouter(prefix="/api/v1/products", tags=["products"])


@router.get("", response_model=list[ProductResponse])
async def list_products(
    category: str | None = None,
    session: AsyncSession = Depends(get_session),
) -> list[ProductResponse]:
    # 1.获取Service
    service = ProductService(session)
    # 2.查询并返回产品列表
    return await service.list_products(category)
Router的依赖注入终极优化版本
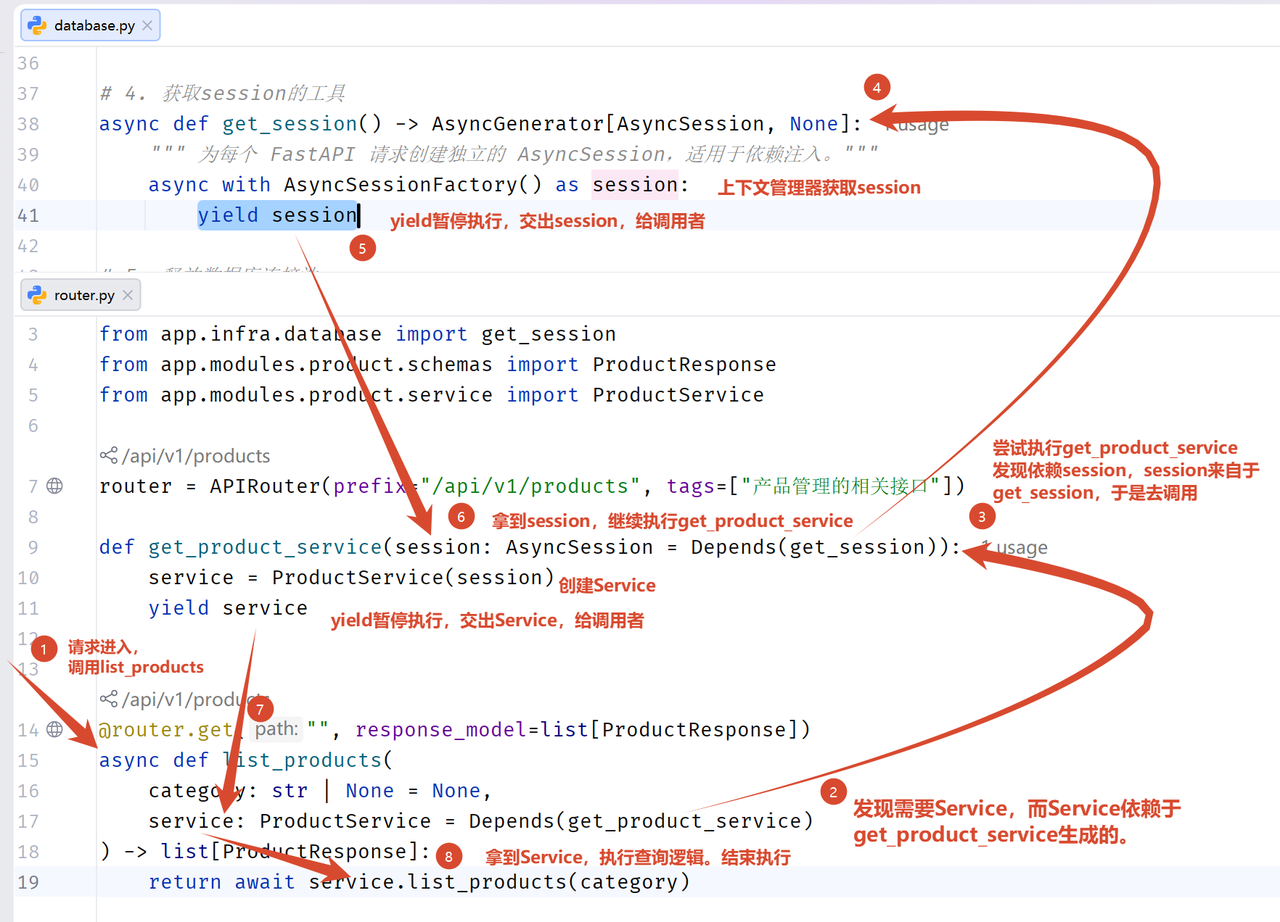
在上面路由的代码中,每次获取service的代码是手动创建对象。如果接口较多,每个接口都手动创建比较麻烦,可以将获取service的代码抽取为公共函数,通过依赖注入来获取。
 # 1.获取Service,每次都需要手动获取一次,操作起来就比较麻烦
service = ProductService(session)既然要在Router通过依赖注入获取Service,而Service的创建又需要依赖Session,为此,我们可以进行链式依赖注入,我们可以分两步进行操作:
- 定义
get_product_service函数,通过依赖注入获取session,创建ProductService。 - 在
list_products的参数列表中,通过依赖注入获取service。
具体代码,如下,可以优化到app.modules.product 包中的 router.py模块。
async def get_product_service(
    session: AsyncSession = Depends(get_session),
) -> ProductService:
    return ProductService(session)


@router.get("", response_model=list[ProductResponse])
async def list_products(
    category: str | None = None,
    service: ProductService = Depends(get_product_service),
) -> list[ProductResponse]:
    return await service.list_products(category)
那么上面的代码一共进行了两次链式依赖注入,具体的流程参考图如下:
统一异常处理
先抽取一个共同的异常基类。异常基类属于项目级能力,应该放在 app.core 包中,新建 exceptions.py 文件。
内容如下:
class ApplicationError(Exception):
    """应用业务异常基类"""

    status_code: int = 500                # 默认状态码
    code: str = "APPLICATION_ERROR"       # 默认异常code
    message: str = "服务器内部错误"        # 默认异常提示
说明
说明:
status_code表示 HTTP 状态码code表示客户端识别的业务错误码message表示错误提示
这里提供默认值,具体业务异常会覆盖这些字段。
改造业务异常
在具体的业务模块中如product模块新建一个exceptions的文件,让自定义异常继承 ApplicationError,并把原来写在 Router 中的响应信息移到异常类中。
from app.core.exceptions import ApplicationError


class ChatThreadNotFoundError(ApplicationError):
    """会话不存在或不属于当前用户"""

    status_code = 400
    code = "CHAT_THREAD_NOT_FOUND"
    message = "会话不存在或不属于当前用户"
全局异常处理
from fastapi import FastAPI, Request
from fastapi.responses import JSONResponse
from app.core.exceptions import ApplicationError

# 然后在创建 FastAPI 实例之后注册全局异常处理器。
@app.exception_handler(ApplicationError)
async def handle_application_error(
    request: Request,
    exc: ApplicationError, # 捕获到的异常(这里用自定义异常基类捕获,所有业务异常都会匹配到)
) -> JSONResponse:
    return JSONResponse(
        status_code=exc.status_code, # 异常中自带status
        content={
            "code": exc.code,        # 异常中自带code
            "message": exc.message,  # 异常中自带message
        },
    )
FastAPI 捕获到 ApplicationError 或它的任意子类后,都会进入这个处理器,再根据异常对象中的字段生成响应。以后新增业务异常时,不需要继续给 app.main.py 添加处理器。
提示
统一处理的是我们主动定义的业务异常。请求参数校验异常、程序 Bug 等其他异常仍然由 FastAPI 自身处理,不要把所有异常都转换成业务错误。
基于postgresql实现会话记忆
PostgreSQL Checkpointer 不包含在 LangChain 的基础依赖中,需要单独安装,执行下面的命令:
uv add langgraph-checkpoint-postgres "psycopg[binary,pool]"两个依赖的作用如下:
langgraph-checkpoint-postgres:提供PostgresSaver和AsyncPostgresSaver;psycopg[binary,pool]:负责连接 PostgreSQL,并提供异步连接池支持。
当前项目基于 FastAPI 异步开发,因此后面使用的是 AsyncPostgresSaver。
配置数据库的连接
项目中的 SQLAlchemy 使用 asyncpg 驱动,而 PostgreSQL Checkpointer 使用 psycopg 驱动。二者访问的是同一个数据库,只是连接地址的协议不同,因此,不需要新增一套数据库环境变量,只要根据现有配置生成两种连接地址即可。
| 使用位置 | 连接协议 | 示例 |
|---|---|---|
| SQLAlchemy | postgresql+asyncpg | postgresql+asyncpg://insurance:***@localhost:5432/insurance |
| PostgreSQL Checkpointer | postgresql | postgresql://insurance:***@localhost:5432/insurance |
修改 app.core.config.py 中的 DatabaseSettings,分别定义 url 和 checkpoint_url。
class DatabaseSettings(EnvSettings):
    """数据库相关设置"""

    host: str = Field(alias="DB_HOST", default="localhost")
    port: int = Field(alias="DB_PORT", default=5432)
    name: str = Field(alias="DB_NAME", default="insurance")
    user: str = Field(alias="DB_USER", default="insurance")
    password: str = Field(alias="DB_PASSWORD", default="insurance123")
    echo: bool = Field(alias="DB_ECHO", default=False)
    pool_size: int = Field(alias="DB_POOL_SIZE", default=5)
    max_overflow: int = Field(alias="DB_MAX_OVERFLOW", default=10)
    pool_timeout: int = Field(alias="DB_POOL_TIMEOUT", default=30)
    pool_recycle: int = Field(alias="DB_POOL_RECYCLE", default=1800)

    @computed_field
    @property
    def url(self) -> str:
        return PostgresDsn.build(
            scheme="postgresql+asyncpg",
            host=self.host,
            port=self.port,
            username=self.user,
            password=self.password,
            path=self.name,
        ).encoded_string()

    @computed_field
    @property
    def checkpoint_url(self) -> str:
        return PostgresDsn.build(
            scheme="postgresql",
            host=self.host,
            port=self.port,
            username=self.user,
            password=self.password,
            path=self.name,
        ).encoded_string()
FastAPI管理Checkpointer生命周期
由于Checkpointer也有连接池,避免每次请求都要重新创建一个Checkpointer,需要和SqlAlchemy一样,在项目启动时初始化,在项目停止时关闭,也就是交给FastAPI的统一生命周期管理,处理方式相同:
- FastAPI 启动时,打开 Checkpointer 连接池并完成初始化;
- FastAPI 运行期间,所有 Agent 共用同一个 Checkpointer;
- FastAPI 关闭时,关闭连接池并释放数据库连接。
封装checkpointer
和database一样,checkpointer 属于项目的基础设施,因此应该放在 app.infra 包中,新建 checkpointer.py 文件。
from langgraph.checkpoint.postgres.aio import AsyncPostgresSaver
from psycopg.rows import dict_row
from psycopg_pool import AsyncConnectionPool

from app.core.config import settings
from app.core.logging import get_logger

logger = get_logger(__name__)

# 0.创建checkpointer专用连接池
checkpoint_pool = AsyncConnectionPool(
    conninfo=settings.db.checkpoint_url,
    min_size=1,  # 池最小连接数
    max_size=5,  # 池最大连接数
    kwargs={
        "autocommit": True,  # 自动提交事务
        "prepare_threshold": 0,  # 不做预准备sql
        "row_factory": dict_row,  # 查询结果以dict返回
    },
    open=False,  # 不自动创建连接
)


async def init_checkpointer() -> AsyncPostgresSaver:
    """初始化checkpointer"""

    # 1.初始化连接池
    await checkpoint_pool.open() # 初始化连接
    await checkpoint_pool.wait() # 等待连接池就绪

    # 2.创建checkpointer
    checkpointer = AsyncPostgresSaver(checkpoint_pool)
    await checkpointer.setup()
    logger.info("Checkpointer初始化成功~✅️")
    return checkpointer


async def close_checkpointer() -> None:
    """关闭Checkpointer连接池"""
    await checkpoint_pool.close()
    logger.info("Checkpointer连接池已关闭")
注意
- 这里把连接池定义成模块级对象,是为了让整个应用只创建一份。而且这里
open=False,并不会立刻创建连接,而是在init_checkpointer中才利用open()初始化连接。 init_checkpointer()初始化连接,并等待连接池就行,然后返回初始化后的 Checkpointer,后面创建保险顾问 Agent 时会继续使用这个返回值。应该在项目启动时执行。close_checkpointer()负责管理连接池,应该在项目停止前执行
管理生命周期
项目的 app.main.py 中已经定义了 lifespan,目前只管理了SQLAlchemy数据库连接池,接下来把 Checkpointer 也加入其中。
在 app.main.py中,修改 lifespan()。
@asynccontextmanager
async def lifespan(app:FastAPI):
    """
    生命周期管理函数
    :param app: FastAPI实例
    """
    # 1.FastAPI刚刚启动的时候执行的代码逻辑
    # 1.1 导入check_database和close_database,加载database模块
    from app.infra.database import check_database, close_database
    # 1.2 执行数据库连接的初始化操作
    await check_database()
    logger.info("数据库连接初始化完成~")
    # 1.3 导入初始化方法和关闭方法(checkpointer)
    from app.infra.checkpointer import init_checkpointer,close_checkpointer
    # 1.4 执行初始化操作
    checkpointer = await init_checkpointer()
    yield
    # 2.项目关闭的时候执行的一些代码逻辑
    # 2.1 执行数据库连接的关闭操作
    await close_database()
    logger.info("数据库连接关闭完成~")
    # 2.2 执行关闭数据库连接池的方法
    await close_checkpointer()
事件循环错误
重启测试项目,可能会看到如下错误信息。
error connecting in 'pool-1': Psycopg cannot use the 'ProactorEventLoop' to run in async mode. Please use a compatible event loop, for instance by setting 'asyncio.set_event_loop_policy(WindowsSelectorEventLoopPolicy())'只需要修改 app.main.py 底部的启动代码,在 Windows 下通过导入字符串把 SelectorEventLoop 交给 Uvicorn,其他系统仍然使用默认配置。(项目搭建阶段已经设置过了)
if __name__ == "__main__":
    uvicorn.run(
        app,
        host=settings.app.host,
        port=settings.app.port,
        reload=False,
        loop= "asyncio:SelectorEventLoop" if sys.platform == "win32" else "auto",
    )
注意
由于我们是在app.main中设置了uvicon的启动loop,所以启动命令必须是通过:
uv run python -m app.main来运行,不能是uvicorn app.main:app
会话历史管理
前面已经使用 Checkpointer 为 Agent 增加了会话记忆。用户在同一个会话中继续提问时,Agent 能够读取之前的消息并结合上下文回答。
不过,Agent 能记住历史并不代表前端能看到历史,还有两个事要做:
- 用户刷新页面或重新打开一个旧会话时,前端仍然需要调用接口查询消息,再把用户和 AI 的历史对话重新渲染出来。
- 删除会话时,也不能只删除
chat_threads中的会话记录,还要清理 Checkpointer 保存的状态。
获取对话历史
之前学习会话记忆时说过,每一次与AI交互,都会产生一次State快照。
这些State快照都属于同一个会话,因此有相同的thread_id,而最新的快照包含最完整的历史消息,所以我们只需要获取最新的快照就可以了。
在Agent中,提供了一个 aget_state(),可以读取该会话最新的 State 快照。
snapshot = await agent.aget_state(config)返回值是一个 StateSnapshot 对象,结构大致如下。
StateSnapshot(
    values={"messages": [...]},
    next=(),
    config={...},
    metadata={...},
    created_at="...",
    parent_config={...},
    tasks=(),
    interrupts=(),
)
字段解释如下:
| 字段 | 说明 |
|---|---|
values****(重点关注) | 当前 State 中保存的数据,Agent 的历史消息位于 values["messages"] |
next | 接下来等待执行的节点;Agent 本轮执行结束后通常为空 |
config | 当前快照的配置,其中包含 thread_id 和 Checkpoint 标识 |
metadata | 快照的来源、执行步骤等元数据 |
created_at | 快照创建时间 |
parent_config | 上一个快照的配置,用于连接前后状态 |
tasks | 当前快照中的待执行任务 |
interrupts | 尚未处理的中断信息,后面实现人工确认时会用到 |
StateSnapshot 保存的是 Agent 在某个时刻的完整状态,历史消息则保存在 values中,取出 values["messages"],就可以获取所有历史记录。
messages = snapshot.values.get("messages", [])删除会话状态
之前说过,每一轮会话都会产生一个快照,会话在多轮交互中会产生很多快照了。
aget_state() 是 Agent 提供的状态读取方法,只能拿到最新快照。
而要删除会话,就不仅仅删最新的,而是要把所有的快照都删除,这就要由 checkpointer 负责了。
checkpointer中提供了 adelete_thread(),可以删除指定 thread_id 的全部快照
thread_id = config["configurable"]["thread_id"]
await checkpointer.adelete_thread(thread_id)删除后再次读取最新快照,能够发现,此时输出为空字典 {},说明该会话的状态和历史消息已经被清理。
snapshot = await agent.aget_state(config)
print(snapshot.values)
初始化agent
Checkpointer已经交给FastAPI 管理,接下来可以使用它创建项目中的保险顾问 Agent。
Agent 在运行期间需要一直使用同一个 Checkpointer,同样为了避免每次收到请求时都重新创建 Agent,应该只在应用启动时创建一次 Agent,并把它保存到 FastAPI 的 app.state 中,后续所有请求共同使用。
app.state
app.state 是FastAPI的共享状态,用来保存与当前 FastAPI 应用实例共同存在的对象,比如我们即将创建一个全局共享使用的智能体:app.state.agent。
后面任何接口需要使用共享对象时,都可以通过 request.app.state.agent 获取这里创建的 Agent,不需要重新初始化。
智能体的定义
新建agents包,并创建你的智能体项目名称.py 文件,参考代码如下:
# 目标:创建保险顾问智能体 - init_insurance_agent(checkpointer:AsyncPostgresSaver)
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langgraph.checkpoint.postgres.aio import AsyncPostgresSaver

from app.core.config import settings
from app.core.logging import get_logger

logger = get_logger(__name__)

SYSTEM_PROMPT="""
你是“安心保”的智能保险顾问。
你需要使用专业、准确、容易理解的语言回答用户的保险问题。
当信息不足时,应先向用户追问,不要编造保险产品或保障内容。"""

async def init_insurance_agent(checkpointer:AsyncPostgresSaver):
    # 1.准备模型
    model = init_chat_model(
        model="deepseek-flash",
        api_key=settings.llm.api_key,
        model_provider="deepseek",
        extra_body={"thinking":{"type":"disabled"}}
    )
    # 2.准备工具
    tools = []
    # 3.准备系统提示词
    # 4.创建智能体
    agent = create_agent(
        model=model,
        tools=tools,
        checkpointer=checkpointer,
        system_prompt=SYSTEM_PROMPT
    )

    logger.info("保险顾问智能体启动完成~")
    return agent
当前 Agent 暂时没有工具,只具备基础对话和会话记忆能力,后面实现保险产品查询、产品推荐和推荐方案生成时,再逐步把工具加入 tools。
交给FastAPI管理
在app.main.py中,继续修改 lifespan(),基于checkpointer创建智能体,并将智能体保存到 app.state.agent中,以供后续使用,完整代码,如下。
@asynccontextmanager
async def lifespan(app:FastAPI):
    """
    生命周期管理函数
    :param app: FastAPI实例
    """
    # 1.FastAPI刚刚启动的时候执行的代码逻辑
    # 1.1 导入check_database和close_database,加载database模块
    from app.infra.database import check_database, close_database
    # 1.2 执行数据库连接的初始化操作
    await check_database()
    logger.info("数据库连接初始化完成~")
    # 1.3 导入初始化方法和关闭方法(checkpointer)
    from app.infra.checkpointer import init_checkpointer,close_checkpointer
    # 1.4 执行初始化操作
    checkpointer = await init_checkpointer()
    # 1.5 创建保险顾问智能体
    from app.agents.insurance_advisor import init_insurance_agent
    agent = await init_insurance_agent(checkpointer)
    app.state.agent = agent

    yield
    # 2.项目关闭的时候执行的一些代码逻辑
    # 2.1 执行数据库连接的关闭操作
    await close_database()
    logger.info("数据库连接关闭完成~")
    # 2.2 执行关闭数据库连接池的方法
    await close_checkpointer()
SSE流式对话
Agent本身的stream模式调用我们已经学会过,也就是**stream_events或astream_events**,但把agent的数据用stream模式逐个片段持续发送到前端,就需要用到SSE技术。
什么是SSE
SSE(Server-Sent Events)是一种基于HTTP协议,使用 text/event-stream 格式,让服务器主动向浏览器推送数据的通信协议。
其核心特点就是:客户端与服务器只建立一次连接,服务端可以进行多次推送数据到客户端,且前端可以自动重连,非常适合大模型输出、Agent 逐步推理这类流式场景。
简单来说,就是前端发起一次请求,服务端以stream方式不断推送新的数据给前端,前端完成渲染,从而实现大模型的流式输出效果。
SSE的数据格式
在标准的SSE中,服务端返回的数据格式是纯文本格式,可以包含event、data、id、retry字段,每个字段后跟冒号和空格,并以\n结束,不同消息之间则以\n\n结束
[field]: [value]\n
[field]: [value]\n
\n\n
支持的字段如下:
| 字段 | 说明 | 示例 |
|---|---|---|
event | 指定事件类型(前端可监听特定事件) | event: message |
data | 实际数据内容(可以是多行,多行会拼接) | data: Hello |
id | 消息ID,客户端可用于断线重连 | id: 1 |
retry | 重连时间(毫秒),客户端断线后等待多久重新连接 | retry: 3000 |
ServerSentEvent
其实,在FastAPI中提供了对于SSE的支持,只需要两步处理:
- 首先,把router的响应类型,
response_class改为EventSourceResponse,EventSourceResponse会自动设置text/event-stream、Cache-Control: no-cache和X-Accel-Buffering: no,并在长时间没有消息时发送保活注释,不需要手动设置这些响应头。 - 其次,用
ServerSentEvent封装返回值,ServerSentEvent的结构大概是这样:
class ServerSentEvent(BaseModel):
    id: str
    event: str
    data: str
    retry: int
# ...只需要我们把结果封装为ServerSentEvent对象,FastAPI即可帮我们以SSE需要的格式返回。
代码参考
from uuid import UUID

from fastapi.sse import ServerSentEvent
from langchain_core.messages import HumanMessage
from langgraph.graph.state import CompiledStateGraph
from sqlalchemy.ext.asyncio import AsyncSession

from app.modules.chat_thread.exceptions import ChatThreadNotFoundError
from app.modules.chat_thread.repository import ChatThreadRepository


class ChatService:
    def __init__(self, session:AsyncSession, agent:CompiledStateGraph):
        self.repository = ChatThreadRepository(session)
        self.agent = agent


    async def chat_stream(self, thread_id:UUID, user_id:int, message:str):
        # 1.验证当前会话是不是属于当前登录的用户
        chat_thread = self.repository.find_owned(thread_id, user_id)
        if chat_thread is None:
            raise ChatThreadNotFoundError

        # 2.目标:通过智能体发送消息给大模型
        # 2.1 准备好消息列表
        _input = {
            "messages":[
                HumanMessage(content=message)
            ]
        }
        # 2.2 准备好配置信息,包括thread_id
        _config = {
            "configurable":{
                "thread_id":str(thread_id)
            }
        }

        # 2.3 通过智能体发送消息给大模型
        response = await self.agent.astream_events(
            _input,
            _config,
            version="v3"
        )
        # 2.4 流式解析:遍历每条消息,再把每条消息的文本片段逐个通过 SSE 推给前端
        """
        Asynchronous per-message streaming object for a single LLM response.
        The stream itself is awaitable (`msg = await stream`) and async-iterable (`async for event in stream`).

        单个LLM响应的异步消息流对象。
        流本身是可唤醒的(`msg = await stream`)和可同步迭代的(`async for event in stream`)。
        """
        # response.messages代表多个消息流,也就是一条条消息,包括:思考流、工具调用流和文本流消息,可以认为是一条条水管~
        # 每一次循环同步拿到一个管道,也就是一个消息流
        async for message in response.messages:
            """
            Text content — async iterable of `str` deltas, awaitable for full text.
            文本内容 - `str`增量的异步可迭代对象,对于全文能够慢慢等着输出。
            """
            # 内层:message.text代表一条消息里的文本流,你可以认为进入到一个水管中了,那水管中就会时不时的从上游流水下来,也就是一个个的文本片段。
            async for text in message.text:
                # 在这儿拿到一个消息片段之后,使用yield,将数据组装成SSE对象放到了一个管道(流)中,往下游流
                yield ServerSentEvent(event="message", data=text)
yield ServerSentEvent(event="done", data="END")stream.messages表示本次 Agent 运行过程中产生的 AI 消息;message.text表示当前消息持续生成的文本片段,每获得一个文本片段,就创建一个事件类型为message的ServerSentEvent;- FastAPI 会自动完成 JSON 编码和 SSE 格式化,不需要手动拼接
event:、data:和空行。
router改造
修改 app.modules.chat.router.py,将路由的 response_class 设置为 FastAPI 原生的 EventSourceResponse,并在路径函数中逐个 yield ServerSentEvent。
from time import sleep
from typing import Annotated

from fastapi import APIRouter, Header, Depends
from fastapi.sse import ServerSentEvent, EventSourceResponse
from sqlalchemy.ext.asyncio import AsyncSession
from starlette.requests import Request

from app.infra.database import get_session
from app.modules.chat.schemas import ChatRequest
from app.modules.chat.service import ChatService

router = APIRouter(prefix="/api/v1/chat", tags=["聊天业务"])

async def get_service(
        request:Request,
        session:AsyncSession = Depends(get_session),
):
    return ChatService(session, request.app.state.agent)

@router.post("", summary="与AI交互聊天", response_class=EventSourceResponse)
async def chat_stream(
    chat_request:ChatRequest,
    user_id:Annotated[int, Header(alias="x-user-id")],
    service:ChatService = Depends(get_service)
):
    # return await service.chat_stream(chat_request.thread_id, user_id, chat_request.message)

    # for i in range(10):
    #     sleep(1)
    #     yield ServerSentEvent(event="message", data=f"message-{i}")
    # yield ServerSentEvent(event="done", data="[DONE]")

    # 作为下游,至少在当前的业务中不需要再对流中的数据进行处理了。
    # 所以每从流中拿到一个SSE对象,直接使用yield将数据放到流中。
    # 其实下游就是EventSourceResponse,那剩下的就是EventSourceResponse的事情了。
    # EventSourceResponse会逐个遍历生成器,每接收到一个数据,会立刻将SSE按照特有的响应头发送到前端~那就结束了,最后一个环节了
    """
    至于为什么使用async for,生成器之间的对接就是靠 async for ... yield 这种写法,记住就可以了。
    以后只要别人给你yield很多数据,你就用async for来同步接收并处理~

    你看,使用yield再配合async,组装一个流还是挺方便的.
    更底层中的流也是使用的yield来回传数据的~直到有人处理这个流中的数据,或者流中的数据被丢掉,一个完整的流式调用链路就算是结束了

    不一定能听懂,已经很底层了,能听懂就听懂,听不懂就记住,流式输出就这么玩儿~
    """
    async for sse in service.chat_stream(chat_request.thread_id, user_id, chat_request.message):
        yield sse