1.基本概念
Milvus是向量数据库,与MySQL这样的关系型数据库一样都是存储数据的,因此在概念上有很多相似之处。
Milvus 中比较核心的概念有 3 个。它们与 MySQL 中的概念相似,但并不完全等价:
| Milvus | MySQL | 含义 |
|---|---|---|
| Collection | Table | 一组结构相同的数据集合 |
| Field | Column | 描述数据的某个属性,例如标题、文本、向量 |
| Entity | Row | Collection 中的一条完整数据 |
MySQL中需要定义表结构,Milvus中也需要定义Collection结构。在Milvus中Collection结构是由Schema来控制的。
Schema 用来定义 Collection 中包含哪些 Field,以及每个 Field 的名称、数据类型和相关属性。
1.1.Schema
常见的 Schema 属性可以按使用场景分为以下几类:
| 适用场景 | 属性 | 说明 |
|---|---|---|
| 通用 | field_name | 字段名称 |
datatype | 字段的数据类型 | |
description | 字段说明 | |
| 主键 | is_primary | 是否为主键 |
auto_id | 是否由 Milvus 自动生成主键 | |
| 字符串 | max_length | 字符串字段的最大长度 |
| 向量 | dim | 向量的维度 |
| 数组 | element_type | 数组中元素的数据类型 |
max_capacity | 数组最多可以保存的元素数量 |
以上属性并不是每个字段都需要配置,而是根据具体的数据类型来选择,Milvus支持的数据类型有很多,常见的有:
VARCHAR:也就是字符串,除了通用属性外,还需要设置max_length属性INT32、INT64:数字,通常设定通用属性即可ARRAY:数组,元素可以是其它类型,数组除了通用属性,还需要设定下列特有属性element_type:数组中元素类型max_capacity:数组元素数量
1.2.Index
Index,也就是索引,用来提高数据检索速度。根据字段的数据类型不同,Milvus 中常用的索引可以分为三类:
| 数据类型 | 常见索引 | 用途 |
|---|---|---|
| 稠密向量 | AUTOINDEX、HNSW、IVF_FLAT | 加速向量相似度检索 |
| 稀疏向量 | SPARSE_INVERTED_INDEX | 加速稀疏向量检索 |
| 标量字段(普通字段) | INVERTED、BITMAP | 条件过滤,缩减向量检索范围 |
例如,一个保险产品文档切片:
{
  "product_name": "达尔文12号重大疾病保险",
  "category": "重疾险",
  "content": "等待期后,被保人首次确诊合同约定的重大疾病,保险公司按照基本保险金额给付重大疾病保险金。"
}
保存到 Milvus 时,这条文档可以同时包含下面几类数据:
| Field | 示例数据 | 数据类型 | 作用 |
|---|---|---|---|
product_name | 达尔文12号重大疾病保险 | 普通字段 | 条件过滤 |
category | 重疾险 | 普通字段 | 条件过滤 |
content | 等待期后,被保险人首次确诊…… | 普通字段 | 展示 |
dense_vector | [0.12, -0.35, 0.67, ...] | 稠密向量 | 向量检索 |
sparse_vector | {1: 0.8, 3: 0.9, ...} | 稀疏向量 | 向量检索 |
其中:
content:也就是文档片段的原始内容,它的作用有两个,- 用来生成向量,
- 作为查询结果返回,也就是RAG检索的文档原文
product_name、category是文档原本的字段,用于条件过滤。类似数据库的where key = valuedense_vector、sparse_vector属于是衍生字段,通常是根据content内容向量化得来。
标量字段,也就是普通字段是类似于where条件的过滤,比较简单。
1.2.1.稠密向量
在之前学习RAG时,我们使用 Embedding 模型将文本转换成向量,再根据向量相似度检索语义相近的文档。这里生成的就是稠密向量。
[0.12, -0.35, 0.67, 0.28, ...]稠密向量的维度是固定的,例如qwen3-embedding:0.6b生成的是1024维的向量。并且大部分位置都有数值,所以称为“稠密”。
稠密向量中的数值共同表示文本的语义,基于稠密向量的相似度检索就是根据语义检索,即使用户使用了不同的表达方式,只要含义相近,哪怕是写错字也可能检索到相关内容。
例如:
- 原始文档:
2.1.免责声明:遇到以下情形之一,不予理赔... - 用户问题:
什么情况下保险不能赔?
两句话用词不同,但语义接近,稠密向量检索通常能够找到对应文档。
1.2.2.稀疏向量
如果说稠密向量是基于语义的检索,那稀疏向量则是基于关键词的检索。
稠密向量擅长理解语义,但在产品名称、疾病名称、条款编号等需要精确匹配的场景中不一定稳定。特别是一些专业词汇,一字之差意思就完全不同。
例如,知识库中有两份保险条款:
- 文档 A:本产品保障甲状腺乳头状癌。 ---> 产品 保障 甲状腺 乳头状癌
- 文档 B:本产品保障甲状腺髓样癌。 ---> 产品 保障 甲状腺 髓样癌
用户询问:“甲状腺髓样癌是否可以赔付?” ---> 甲状腺 髓样癌 赔付
两份文档都包含“甲状腺”和“癌”,整体语义也非常接近。稠密向量检索可能认为它们都与问题高度相关,甚至把错误的文档 A 排在前面。
稀疏向量检索则会重点关注“髓样癌”这个关键词,使包含完全匹配词语的文档 B 获得更高分。
那么问题来了:
什么是稀疏向量呢?它如何实现关键词检索呢?
稀疏向量通常会有一份人类语言的词表。词表就是系统能够识别的所有词语集合,一个词表通常有几万到几十万词语,每个词语在词表中都有一个固定位置。例如下面这个简化的词表:
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | ... | 100000 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 医疗险 | 重疾险 | 意外险 | 被保人 | 等待期 | 保险金 | 投保年龄 | 保费 | 免责条款 | 续保 | ... | xxx |
文档转为稀疏向量,就是把文档中出现的重要词语在词表对应位置上给权重值,其他位置则是 0。
示例文档含有:被保人、等待期、保险金,等词语,转换后的稀疏向量可以简化表示为:
[0, 0, 0, 0.9, 0.6, 0.7, 0, 0, 0, 0]实际系统中的词表可能包含几万甚至几十万词语,因此稀疏向量的维度通常很高。但是,一段文档只会涉及词表中的少量词语,所以绝大多数位置都是 0,这就是“稀疏”的含义。
为了节省存储空间,实际使用时不需要保存大量的 0,只需要记录非零位置和对应的权重:
{
    3: 0.9,
    4: 0.6,
    5: 0.7
}比较稀疏向量相似度,就是看关键词的出现位置和权重等是否接近,所以稀疏向量检索更擅长关键词的精确匹配检索。例如:地名、人名、医疗词汇等专有名词或者编号。
说明
稀疏向量的词条权重有两种获取方式:
- 统计式:
BM25算法、TF/IDF算法等都是基于词频统计的稀疏检索算法,需要的计算资源较少,速度快 - 学习式:
BGE-M3、SPLADE,是基于神经网络模型训练实现稀疏检索,需要的计算资源多(GPU),速度慢,但理解能力会更强(带有一定的语义分析)
1.2.3.索引类型
由于稀疏向量、稠密向量、普通字段,在数据格式上有很大差别,因此建立索引的方式也不同。
| 数据类型 | 保存的内容 | 常见索引 |
|---|---|---|
| 稠密向量 | 文本的语义特征 | AUTOINDEX、HNSW、IVF_FLAT |
| 稀疏向量 | 关键词及其权重 | SPARSE_INVERTED_INDEX |
| 普通字段 | 名称、分类、状态等业务数据 | INVERTED、BITMAP |
实际检索时,三类索引可以配合使用:
- 先用普通字段索引过滤数据,缩小数据检索范围,
- 再用稠密向量索引匹配语义,稀疏向量索引匹配关键词。
稠密向量和稀疏向量不是替代关系,而是互补关系,实际中经常会同时使用两种检索方式,也就是混合检索。
提示
在Milvus中内置了BM25的稀疏向量实现,所以后续我们会直接使用基于BM25的稀疏向量来演示。
1.3.总结
Milvus 是面向向量检索的数据库。除了向量之外,它也可以保存字符串、数字、数组等普通字段,并支持对这些字段创建索引和进行条件过滤。
Milvus的概念与MySQL很相似:
- MySQL 使用 Table 组织数据,Milvus 使用 Collection;
- MySQL 表有列,也就是字段;Milvus 的Collection有Field;
- MySQL 创建表时需要定义列,Milvus 通过 Schema 定义 Field;
- MySQL 和 Milvus 都可以通过索引提高检索效率,但 Milvus 需要根据向量字段和普通字段选择不同的 Index。
所以,我们要使用Milvus,也和使用MySQL的步骤类似:
- 定义 Collection 的字段结构,也就是 Schema;(MySQL定义表中每一个列的约束)
- 配置字段索引,也就是 Index;(MySQL的字段索引)
- 根据 Schema 和 Index 创建 Collection。(MySQL创建表)
2.2.Milvus的使用
2.2.1.安装依赖
uv add pymilvus2.2.2.环境变量配置
Milvus也是数据库,需要将其URL地址配置到环境变量中。
我们修改.env文件,添加下面的配置:
# milvus
MILVUS_HOST=192.168.150.101
MILVUS_PORT=19530然后,修改app.core.config.py文件,在RAGSettings中添加下面的配置:
这个文件也可以由我们自定义决定,具体的代码参考如下即可:
class RAGSettings(EnvSettings):
    """RAG相关配置"""
    mineru_token: str = Field(alias="MINERU_TOKEN")
    milvus_host: str = Field(alias="MILVUS_HOST", default="127.0.0.1")
    milvus_port: int = Field(alias="MILVUS_PORT", default=19530)

    @computed_field
    @property
    def milvus_url(self) -> str:
        return f"http://{self.milvus_host}:{self.milvus_port}"
2.2.3.准备文档
准备一份md文档,此处我们直接跳过了使用MinerU解析PDF的过程,直接生成了md文档进行解析。此处按照md文档的根据结构感知进行切分。
from langchain_text_splitters import MarkdownHeaderTextSplitter

def prepare_docs():
    # =============1.准备文档================
    with open('./resources/评估.md', 'r', encoding='utf-8') as f:
        doc = f.read()

    # =============2.切分文档================
    # 切分依据,这里是按照三级标题
    headers_to_split_on = [
        ("#", "h1"),
        ("##", "h2"),
        ("###", "h3"),
    ]

    # 创建切分器
    markdown_splitter = MarkdownHeaderTextSplitter(
        headers_to_split_on,
        strip_headers=False  # 在正文中是否去除标题,False,不去除
    )

    # 切分文档, 返回的是 list[Document]
    docs = markdown_splitter.split_text(doc)

    return docs

docs = prepare_docs()
切好之后的文档格式应该是这样的:
{
  "id": null,
  "metadata": {
    "h1": "第一章 教育概述",
    "h2": "第一节 中外教育家及其教育思想",
    "h3": "(一)教育学萌芽时期代表作"
  },
  "page_content": "# 第一章 教育概述  \n## 第一节 中外教育家及其教育思想  \n### (一)教育学萌芽时期代表作  \n国内:《学记》,世界最早,成文于战国末期,作者是乐正克。  \n国外:昆体良《雄辩术原理》/《论演说家的教育》。",
  "type": "Document"
}
2.2.4.向量模型
默认使用OllamaEmbedding模型:
from langchain_ollama import OllamaEmbeddings

# 1.初始化向量模型,可以把文档转稠密向量
embeddings = OllamaEmbeddings(
    model="qwen3-embedding:0.6b",  # 性价比高的模型
    dimensions=1024  # 可选:减少维度以节省存储
)
也可以使用阿里云的向量模型:
from pydantic import SecretStr
from langchain_openai import OpenAIEmbeddings
import os
from dotenv import load_dotenv

load_dotenv() # 加载环境变量

dashscope_base_url = os.getenv('DASHSCOPE_BASE_URL')
dashscope_api_key = os.getenv('DASHSCOPE_API_KEY', '')

# 使用openai规范连接阿里云平台使用其嵌入模型
embeddings = OpenAIEmbeddings(
    base_url=dashscope_base_url,
    api_key=SecretStr(dashscope_api_key),
    model='qwen3.7-text-embedding',
    check_embedding_ctx_length=False  # 取消向量长度检查
)
2.2.5.Collection操作
接下来,我们来演示Milvus的客户端操作collection。
创建一个Collection的操作分为3步:
- 定义Schema,也就是Field约束
- 定义Index,也就是添加索引
- 创建Collection,调用
client.create_collection,传入collection_name:collection名称schema:前面定义的schema信息index_params:前面定义的index信息
2.2.5.1.连接客户端
初始化Milvus的客户端:
from pymilvus import MilvusClient
from app.core.config import settings

# 初始化客户端
client = MilvusClient(uri=settings.rag.milvus_url)

# Collection名称
collection_name = "my_collection_1"
2.2.5.2.创建collection
之前我们准备好的文档结构是这样的:
{
  "id": 1,
  "metadata": {
    "h1": "第一章 教育概述",
    "h2": "第一节 中外教育家及其教育思想",
    "h3": "(一)教育学萌芽时期代表作"
  },
  "page_content": "# 第一章 教育概述  \n## 第一节 中外教育家及其教育思想  \n### (一)教育学萌芽时期代表作  \n国内:《学记》,世界最早,成文于战国末期,作者是乐正克。  \n国外:昆体良《雄辩术原理》/《论演说家的教育》。",
  "type": "Document"
}
我们来分析下文档的Schema,也就是需要的Field:
id:文档唯一标识,INT类型,一定需要,而且是主键metadata:元数据,也就是标题信息,可以作为过滤字段,我们存储一个h2进去演示用,VARCHAR类型page_content:原始文档内容,VARCHAR类型,稀疏和稠密向量都根据它生成
除了这3个基本字段,我们还需存储稀疏和稠密向量,用于检索文档。这两个字段属于是衍生字段,可以自定义:
dense:稠密向量,类型是FLOAT_VECTORsparse:稀疏向量,类型是SPARSE_FLOAT_VECTOR
参考的代码如下:
from pymilvus import Function, FunctionType, DataType

def create_collection():
    # 1.schema
    schema = client.create_schema(
        auto_id=False,  # 不自动生成id
        enable_dynamic_field=False,  # 是否允许动态字段
    )

    # 1.1.主键字段
    schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True)
    # 1.2.稠密向量字段
    schema.add_field(field_name="dense", datatype=DataType.FLOAT_VECTOR, dim=1024)
    # 1.3.稀疏向量字段
    schema.add_field(field_name="sparse", datatype=DataType.SPARSE_FLOAT_VECTOR)
    # 1.4.普通元数据字段,用来做数据过滤
    schema.add_field(field_name="h2", datatype=DataType.VARCHAR, max_length=128)
    # 1.5.原始文档内容,需要被向量化
    schema.add_field(
        field_name="content",
        datatype=DataType.VARCHAR,
        max_length=2048,
        enable_analyzer=True,  # 允许对该字段分词,转BM25稀疏向量
        analyzer_params={"type": "chinese"}  # 指定分词方式,这里选择中文分词
    )
    # 1.6.添加BM25函数,可以自动把原始文档转BM25向量存储
    bm25_function = Function(
        name="text_bm25_emb",  # Function name
        input_field_names=["content"],  # 包含原始文档数据的字段的名称
        output_field_names=["sparse"],  # 稀疏向量字段的名称
        function_type=FunctionType.BM25,  # Set to `BM25`
    )
    schema.add_function(bm25_function)

    # 2.索引
    index_params = client.prepare_index_params()
    # 2.1.稠密向量索引
    index_params.add_index(
        field_name="dense",  # 字段名
        index_type="AUTOINDEX",  # 稠密向量索引方式
        metric_type="COSINE"  # 相似度计算方式,COSINE、IP
    )
    # 2.2.稀疏向量索引
    index_params.add_index(
        field_name="sparse",  # 字段名
        index_type="SPARSE_INVERTED_INDEX",  # 稀疏向量,采用倒排索引
        metric_type="BM25",  # 相似度计算方式,支持 BM25、IP
    )
    # 2.3.普通字段索引
    index_params.add_index(field_name="h2", index_type="AUTOINDEX")

    # 3.创建collection
    client.create_collection(
        collection_name=collection_name,
        schema=schema,
        index_params=index_params
    )

create_collection()
请注意
这里比较特殊的就是稀疏向量字段,我们不是手动把原始文档内容content转为稀疏向量,而是配置了Milvus内置的bm25_function,其关键配置是:
input_field_names:输入字段,就是原始文档字段,本例中是contentoutput_field_names:输出字段,就是保存稀疏向量的字段,本例中是sparse
将来,Milvus会在存储阶段和检索阶段自动帮我们生成稀疏向量:
- 存储文档时,
bm25_function会自动根据content内容生成稀疏向量,存入sparse字段中 - 检索文档时,
bm25_function会自动根据用户问题生成稀疏向量,作为检索条件
但需要特别注意的是,input_field_names指定的字段必须配置两个参数:
enable_analyzer=True:允许对该字段分词,转BM25稀疏向量analyzer_params={"type": "chinese"}: 指定分词方式,这里选择中文分词
2.2.5.3.查看collection
# 查看Collection
res = client.list_collections()

print(res)  # ['my_collection_1']
2.2.5.4.删除collection
# 删除Collection
client.drop_collection(collection_name=collection_name)
2.2.6.Entity操作
准备好了Collection,就可以开始写入文档数据了,也就是Entity.
Entity有三种常见操作:
insert:新增Entity,Entity格式为dict,可以是单个,也可以是listupsert:新增或更新,原理是先根据id删除旧的,再填入新的,如果id不存在则等同于新增delete:删除,可以根据filter条件(非向量字段)删除、根据id删除
2.2.6.1.insert
先把前面切分的文档向量化,注意这里只有稠密向量,稀疏向量由Milvus的BM25函数自动生成:
# 把文档向量化,要传入list[str]
# [文档1,文档2,文档3....]
# [文档1向量,文档2向量,文档3向量....]
# 这里调用的是批量向量化的操作
vectors = embeddings.embed_documents([doc.page_content for doc in docs])
然后存入Collection:
# milvus接收的是dict,所以先做数据转换,稀疏向量不需要我们进行处理!!!!!
data = [
    {
        "id": i+1,
        "content": doc.page_content,
        "h2": doc.metadata.get("h2", ""),
        "dense": vectors[i],  # 稠密向量字段
    }
    for i, doc in enumerate(docs)
]
# 插入
res = client.insert(collection_name, data)
print(res)

#{'insert_count': 21, 'ids': [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21]}
2.2.6.2.upsert
upsert会先根据id删除旧的,再新增一条数据:
- 如果id存在,等同于更新
- 如果id不存在,等同于新增
# 1.准备两条数据

# id为1的数据,修改其h2字段值,模拟更新
data1 = data[0]
data1['h2'] = "测试一下"

 # id为2的数据,将其id修改为88,模拟新增
data2 = data[1]
data2['id'] = 88

# 2.测试upsert
res = client.upsert(collection_name, [data1, data2])
print(res)# {'upsert_count': 2, 'ids': [1, 88]}
2.2.6.3.delete
# 根据id删除
res = client.delete(collection_name, ids=[88])
print(res) # {'delete_count': 1, 'cost': 0}
2.2.7.Search
search 方法是进行向量相似性搜索的核心接口。Milvus的搜索采用了ANN(近似最近邻)算法,搜索效率很高。
提示
最近邻搜索 (Nearest Neighbor Search)是指在给定一个查询向量时,从海量数据集中找到与之距离最近(最相似)的向量。
- 精确最近邻需要遍历整个数据集,计算所有向量与查询向量的距离,这在数据量小、维度低时可行,但一旦数据达到百万、亿级且维度高达几百甚至上千,暴力搜索就变得不可行。
- 近似最近邻需要先对原始数据集进行预处理,建立一种特殊的索引结构。这个结构可以是树、图、哈希表或量化码本,目的是将相似的向量“聚类”或“链接”在一起,以便在搜索时快速缩小范围。给定查询向量,利用索引结构快速定位到候选区域。在这些候选区域中进行距离计算,返回最相似的K个结果。
近似最近邻的核心思想是: 在可接受的精度损失下,大幅提升搜索速度 。也就是说,它找到的可能不是绝对最近的邻居,但通常是“足够近”的,并且搜索时间可以快几个数量级。
类比:
- 精确搜索 :你在图书馆找一本特定的书,必须一本一本核对书名,直到找到正确的那本
- 近似搜索 :你根据图书分类、热门程度、作者等线索,直接去可能包含目标书的几个书架查找,虽然有可能错过,但绝大多数时候你能很快找到很接近的书。
2.2.7.1.参数速查
其常用参数及核心作用总结如下:
| 参数名 | 类型/结构 | 作用与说明 | 是否必填 |
|---|---|---|---|
collection_name | string | 指定要执行搜索的目标集合名称。 | 是 |
data | list / list[list] | 查询向量。可以是单个向量或包含多个向量的批量请求。 | 是 |
anns_field | string | 指定集合中用于存储向量的字段名称。比如你要查询的是稀疏向量,就使用稀疏向量的字段名称,稠密向量同理。 | 通常必填 |
limit | int | 返回与查询向量最相似的结果数量(即 top-K)。 | 是 |
search_params | dict | 配置搜索的详细参数。常用键值对示例:- "metric_type": 度量类型,如 "IP"(内积)、"L2"(欧氏距离)。- "offset": 与 limit 配合实现分页,表示跳过的记录数。- "radius", "range_filter": 用于范围搜索。 | 否 |
filter | string | 在向量搜索前执行的标量过滤表达式(如 "color == 'red'"),用于缩小搜索范围。 | 否 |
output_fields | list[string] | 指定搜索结果中需要返回的实体字段(如 ["id", "color", "price"])。 | 否 |
order_by_fields | list[dict] | 允许按标量字段排序(如 [{"field": "price", "order": "asc"}]),覆盖默认的相似度排序。 | 否 |
ids | list[int] | 通过已存在的主键 ID 替代 data 来指定查询向量。不可与 data 同时使用。 | 否 |
timezone | string | 为本次搜索临时设置 IANA 时区(如 "America/Havana"),用于处理 TIMESTAMPTZ 字段。 | 否 |
使用要点提醒:
- 分页时,
limit与offset的总和不能超过 16384search_params中的metric_type必须与集合索引构建时使用的类型一致ids与data是互斥的,只能提供其中一个
select id, name             # output_fields
from xxx                    # collection_name
where name like "%xx%"      # anns_field data
limit 10
2.2.7.2.稠密向量检索
我们先定义一个稠密检索的函数:
# 稠密向量检索
def dense_query(query: str) -> list[list[dict]]:
    # 1. 对用户的提示词进行向量化处理
    query_vector = embeddings.embed_query(query)

    # 2. 执行稠密向量的相似度检索
    return client.search(
        collection_name=collection_name,  # 查询的集合名称
        data=[query_vector],  # 查询的向量数据
        limit=5,
        anns_field='dense',  # 查询的向量字段
        search_params={"metric_type": "COSINE"},  # 搜索参数,这里使用余弦相似度
        output_fields=['id', 'h2', 'content']  # 输出的字段
    )
2.2.7.2.1.语义相似查询
稠密检索擅长语义相似度查询,用户输入模糊信息,也能检索到:
import json

# 测试稠密向量(语义检索)
result = dense_query('教育的负面作用是什么')
for hits in result:   # 遍历获取每一个查询向量的命中数据
    for hit in hits:  # 变量查询向量的命中的文档列表
        print(json.dumps(hit,indent=2,ensure_ascii=False))
结果参考如下:
{
  "id": 15,
  "distance": 0.6622759103775024,
  "entity": {
    "h2": "第一节 教育的功能",
    "content": "# 第二章 教育基本原理  \n## 第一节 教育的功能  \n### (一)个体发展功能和社会发展功能  \n教育的正向功能(积极功能)指教育有助于社会进步和个体发展的积极影响和作用。  \n教育的负向功能(消极功能)指阻碍社会进步和个体发展的消极影响和作用。  \n教育的显性功能是指教育活动依照教育目的,在实际运行中所出现的与之相吻合的结果。  \n教育的隐性功能指伴随显性功能所出现的非预期性的功能。",
    "id": 15
  }
}
{
  "id": 18,
  "distance": 0.5732588768005371,
  "entity": {
    "h2": "第二节 教育和社会的关系",
    "content": "### (三)文化与教育的关系  \n文化对教育的影响:文化影响着教育的价值取向;文化影响着教育的课程内容;文化影响着育人模式;文化影响着教育教学方法的使用。  \n教育对文化的作用表现在:教育传递和保存文化;教育传播和交流文化;教育选择和提升文化;教育创造和更新文化。",
    "id": 18
  }
}
{
  "id": 19,
  "distance": 0.5514228343963623,
  "entity": {
    "h2": "第二节 教育和社会的关系",
    "content": "### (四)科技与教育的关系  \n科技对教育的作用主要表现在:科技改变着人们关于知识、学习和教育的观念;科技变革着现代教育的课程设置和内容体系;科技变革着现代教育手段、方式和方法。  \n教育对科技的作用主要表现在:教育传播科技;教育创新科技。",
    "id": 19
  }
}
{
  "id": 20,
  "distance": 0.5185043215751648,
  "entity": {
    "h2": "第二节 教育和社会的关系",
    "content": "### (五)人口与教育的关系  \n人口对教育的作用主要表现在:人口的数量和增长是决定教育事业的规模、速度的一个重要因素;人口的质量影响教育的质量;人口的结构影响着教育的发展;人口流动影响着教育的发展。  \n教育对人口的作用主要表现在:控制人口的数量;提高人口的质量;改善人口结构;调整人才构成与流动等作用。",
    "id": 20
  }
}
{
  "id": 21,
  "distance": 0.5133257508277893,
  "entity": {
    "h2": "第二节 教育和社会的关系",
    "content": "### (六)生产力与教育的关系  \n生产力对其它一切因素都起着决定的作用,是决定教育性质的根本因素。  \n生产力对教育的主要作用表现为:生产力发展水平决定着教育事业发展的规模和速度;生产力发展水平制约着人才培养的规格与教育结构;生产力的发展促进教育内容、教学方法和教学组织形式的发展与改革。  \n教育对生产力的作用表现为:教育再生产劳动力;教育是科学知识与技术发展的重要手段。",
    "id": 21
  }
}
2.2.7.2.2.专有名词查询
如果用户搜索的内容是专有名称,就不一定能准确检索了:
import json

# 测试稠密向量(语义检索)
result = dense_query('教育漫画是谁写的')
for hits in result:   # 遍历获取每一个查询向量的命中数据
    for hit in hits:  # 变量查询向量的命中的文档列表
        print(json.dumps(hit,indent=2,ensure_ascii=False))
结果:
{
  "id": 8,
  "distance": 0.48929598927497864,
  "entity": {
    "h2": "第一节 中外教育家及其教育思想",
    "content": "### (八)教育学分化时期代表人物及主要思想  \n**马卡连柯**:著有《教育诗》,提出集体主义教育。  \n**克鲁普斯卡娅**:著有《国民教育与民主制度》,是最早以马克思主义为基础探讨教育问题的教育家。  \n**杨贤江**:著有《新教育大纲》,是中国第一部以马克思主义为指导的教育学著作。  \n**凯洛夫**:著有《教育学》,是世界第一部马克思主义的教育学著作。  \n**布鲁姆**:著有《教学目标分类学》,提出了掌握学习理论:所有学生都能学好;目标分为认知、情感、动作技能。  \n**布鲁纳**:著有《教学过程》,提出了结构主义教学理论,倡导发现式学习。  \n**瓦·根舍因**:著有《范例教学理论》,与布鲁纳和赞可夫被认为课程现代化的三大代表人物。  \n**赞可夫**:著有《教学与发展》,提出了发展性教学理论的五原则:高难度、高速度、理论知识起主导作用、理解学习过程、所有学生包括差生都得到发展的原则。  \n**苏霍姆林斯基**:著有《给教师的建议》《把整个心灵献给孩子》《帕夫雷什中学》,提出个性全面和谐发展的教育思想,他的著作被称为“活的教育学”。  \n**巴班斯基**:著有《教学过程最优化》《教学教育过程最优化》,把现代控制论、系统论观点用于教学论研究,提出教学过程最优化的理论。  \n**皮亚杰**:提出儿童认知发展阶段论、道德发展阶段论,以及儿童与环境互相作用的两个过程:同化、顺应。  \n**维果斯基**:提出心理学的“文化—历史”发展理论;最近发展区理论,教学必须走在发展的前面;支架式教学;“内化”学说。",
    "id": 8
  }
}
{
  "id": 7,
  "distance": 0.46826720237731934,
  "entity": {
    "h2": "第一节 中外教育家及其教育思想",
    "content": "### (七)教育学创立时期代表人物及主要思想  \n**昆体良**:西方第一个专门论述教育问题的教育家。  \n**培根**:在《论科学的价值和发展》中首次把“教育学”作为一门独立的科学确立下来。  \n**夸美纽斯**(教育学之父、教育史上哥白尼):代表作《大教学论》是教育学成为一门独立学科的标志。提出“泛智教育”、“班级授课制”和“学年制”;把教师比喻为太阳底下最光辉的事业。  \n**康德**:教育学作为一门课程在大学里讲授,始于康德。  \n**赫尔巴特**(传统教育代表、科学教育学之父):《普通教育学》是教育学作为一门规范、独立的学科正式诞生的标志。提出以伦理学和心理学作为教育学的基础;教学要有教育性;三中心论:教师、教材、课堂;四阶段论:清楚、联想、系统和方法。  \n**杜威**(现代教育代表、实用主义哲学之父、儿童中心主义论、教育无目的论):《民主主义与教育》提出教育的本质:教育即生活、教育即生长、教育即经验的改组或改造;学校即社会;从做中学;连带学习;三中心论:儿童、经验、活动;五步教学法:设疑—分析—假设—推断—验证。  \n**卢梭**:《爱弥儿》,提倡自然主义教育思想,认为教育的任务应该使儿童归于自然。  \n**洛克**:《教育漫画》,提出白板说,倡导绅士教育。  \n**裴斯泰洛奇**:《林哈德与葛笃德》,教育心理学化。  \n**斯宾塞**:反对思辨,主张用实证方法研究知识价值;生活预备说;科学知识最有价值,制定以科学知识为核心的课程体系。  \n**陶行知**:提出生活教育理论:生活即教育,社会即学校,教学做合一;“捧着一颗心来”(师德);伟大的人民教育家。  \n**蔡元培**:思想自由,兼容并包;以美育代宗教;学界泰斗,人世楷模。",
    "id": 7
  }
}
{
  "id": 6,
  "distance": 0.46553438901901245,
  "entity": {
    "h2": "第一节 中外教育家及其教育思想",
    "content": "### (六)希腊三贤  \n**苏格拉底**:产婆术(谈话法),分三步:讽刺—定义—助产术。国外启发式教育第一人。  \n**柏拉图**:《理想国》提出普及教育的主张,教育目的是培养哲学王。  \n**亚里士多德**:提出自由教育,提倡对学生进行和谐全面发展的教育,灵魂说。",
    "id": 6
  }
}
{
  "id": 11,
  "distance": 0.4492154121398926,
  "entity": {
    "h2": "第三节 教育的起源和发展",
    "content": "## 第三节 教育的起源和发展  \n### (一)教育的起源和发展  \n**神话起源论**:认为教育是由神(上帝或天)所创造的。  \n**生物起源论**:认为教育起源于动物的本能。代表人物:法国的利托尔诺、英国的沛西·能等。  \n**心理起源论**:认为教育起源于儿童对成人无意识的模仿。代表人物:美国的孟禄。  \n**劳动起源论**:认为教育起源于劳动。代表人物:苏联的米丁斯基、凯洛夫。",
    "id": 11
  }
}
{
  "id": 2,
  "distance": 0.4159628450870514,
  "entity": {
    "h2": "第一节 中外教育家及其教育思想",
    "content": "### (二)《学记》主要思想  \n**教育作用**:化民成俗,其必由学;建国君民,教学为先。  \n**教学相长**:教和学两方面互相影响和促进,都得到提高。  \n**豫时孙摩**:包括预防性原则、及时性原则、循序渐进原则、集体教育原则。  \n**长善救失**:“学者有四失,教者必知之。人之学也,或失则多,或失则寡,或失则易,或失则止。此四者,心之莫同也。知其心,然后能救其失也,教也者,长善而救其失者也。”  \n**启发诱导**:道而弗牵,强而弗抑,开而弗达。",
    "id": 2
  }
}
2.2.7.3.稀疏向量检索
稀疏检索刚好与稠密检索相反,擅长关键词匹配,而不擅长语义分析。
我们先定义一个稀疏检索函数:
# 稀疏向量检索
def sparse_search(query: str) -> list[list[dict]]:
    # 执行稀疏向量检索
    return client.search(
        collection_name=collection_name,  # 查询的集合名称
        data=[query],  # 查询的向量数据,内部会自动对用户输入的数据进行BM25计算
        limit=5,
        anns_field='sparse',  # 查询的向量字段
        output_fields=['id', 'h2', 'content']  # 输出的字段
    )
2.2.7.3.1.语义相似查询
如果用户搜索内容与文档意思接近,但内容不同,往往检索不到:
import json

# 测试稀疏向量(关键词检索)
result = sparse_search('教育的负面作用是什么')
for hits in result:   # 遍历获取每一个查询向量的命中数据
    for hit in hits:  # 变量查询向量的命中的文档列表
        print(json.dumps(hit,indent=2,ensure_ascii=False))
结果:
{
  "id": 21,
  "distance": 1.6604101657867432,
  "entity": {
    "h2": "第二节 教育和社会的关系",
    "content": "### (六)生产力与教育的关系  \n生产力对其它一切因素都起着决定的作用,是决定教育性质的根本因素。  \n生产力对教育的主要作用表现为:生产力发展水平决定着教育事业发展的规模和速度;生产力发展水平制约着人才培养的规格与教育结构;生产力的发展促进教育内容、教学方法和教学组织形式的发展与改革。  \n教育对生产力的作用表现为:教育再生产劳动力;教育是科学知识与技术发展的重要手段。",
    "id": 21
  }
}
{
  "id": 20,
  "distance": 1.6471741199493408,
  "entity": {
    "h2": "第二节 教育和社会的关系",
    "content": "### (五)人口与教育的关系  \n人口对教育的作用主要表现在:人口的数量和增长是决定教育事业的规模、速度的一个重要因素;人口的质量影响教育的质量;人口的结构影响着教育的发展;人口流动影响着教育的发展。  \n教育对人口的作用主要表现在:控制人口的数量;提高人口的质量;改善人口结构;调整人才构成与流动等作用。",
    "id": 20
  }
}
{
  "id": 5,
  "distance": 1.597409963607788,
  "entity": {
    "h2": "第一节 中外教育家及其教育思想",
    "content": "### (五)荀子主要思想  \n**人性论**:性恶论,化性起伪,善德是后天习得的,重视教育的作用。  \n**教学原则**:学以致用,锲而不舍。",
    "id": 5
  }
}
{
  "id": 16,
  "distance": 1.4388620853424072,
  "entity": {
    "h2": "第二节 教育和社会的关系",
    "content": "## 第二节 教育和社会的关系  \n### (一)政治与教育的关系  \n政治(经济制度)对教育具有决定作用,是决定教育性质的直接因素。具体表现为:决定了教育的性质和目的;决定了教育的领导权;决定了哪部分社会成员享有受教育的权利;决定了部分的教育内容;决定了教育的管理体制。  \n教育对政治发展的作用表现在:教育促进人的政治社会化;教育培养现代政治法律人才;教育促进现代政治民主化。",
    "id": 16
  }
}
{
  "id": 15,
  "distance": 1.4206510782241821,
  "entity": {
    "h2": "第一节 教育的功能",
    "content": "# 第二章 教育基本原理  \n## 第一节 教育的功能  \n### (一)个体发展功能和社会发展功能  \n教育的正向功能(积极功能)指教育有助于社会进步和个体发展的积极影响和作用。  \n教育的负向功能(消极功能)指阻碍社会进步和个体发展的消极影响和作用。  \n教育的显性功能是指教育活动依照教育目的,在实际运行中所出现的与之相吻合的结果。  \n教育的隐性功能指伴随显性功能所出现的非预期性的功能。",
    "id": 15
  }
}
2.2.7.3.2.专有名词查询
如果用户搜索的内容是专有名称,恰好是稀疏检索擅长的:
import json

# 测试稀疏向量(关键词检索)
result = sparse_search('教育漫画是谁写的')
for hits in result:   # 遍历获取每一个查询向量的命中数据
    for hit in hits:  # 变量查询向量的命中的文档列表
        print(json.dumps(hit,indent=2,ensure_ascii=False))
结果:
{
  "id": 7,
  "distance": 1.972807765007019,
  "entity": {
    "h2": "第一节 中外教育家及其教育思想",
    "content": "### (七)教育学创立时期代表人物及主要思想  \n**昆体良**:西方第一个专门论述教育问题的教育家。  \n**培根**:在《论科学的价值和发展》中首次把“教育学”作为一门独立的科学确立下来。  \n**夸美纽斯**(教育学之父、教育史上哥白尼):代表作《大教学论》是教育学成为一门独立学科的标志。提出“泛智教育”、“班级授课制”和“学年制”;把教师比喻为太阳底下最光辉的事业。  \n**康德**:教育学作为一门课程在大学里讲授,始于康德。  \n**赫尔巴特**(传统教育代表、科学教育学之父):《普通教育学》是教育学作为一门规范、独立的学科正式诞生的标志。提出以伦理学和心理学作为教育学的基础;教学要有教育性;三中心论:教师、教材、课堂;四阶段论:清楚、联想、系统和方法。  \n**杜威**(现代教育代表、实用主义哲学之父、儿童中心主义论、教育无目的论):《民主主义与教育》提出教育的本质:教育即生活、教育即生长、教育即经验的改组或改造;学校即社会;从做中学;连带学习;三中心论:儿童、经验、活动;五步教学法:设疑—分析—假设—推断—验证。  \n**卢梭**:《爱弥儿》,提倡自然主义教育思想,认为教育的任务应该使儿童归于自然。  \n**洛克**:《教育漫画》,提出白板说,倡导绅士教育。  \n**裴斯泰洛奇**:《林哈德与葛笃德》,教育心理学化。  \n**斯宾塞**:反对思辨,主张用实证方法研究知识价值;生活预备说;科学知识最有价值,制定以科学知识为核心的课程体系。  \n**陶行知**:提出生活教育理论:生活即教育,社会即学校,教学做合一;“捧着一颗心来”(师德);伟大的人民教育家。  \n**蔡元培**:思想自由,兼容并包;以美育代宗教;学界泰斗,人世楷模。",
    "id": 7
  }
}
{
  "id": 9,
  "distance": 0.8602669835090637,
  "entity": {
    "h2": "第二节 教育的定义",
    "content": "## 第二节 教育的定义  \n### (一)教育的定义  \n广义的教育是指一切有目的地增进人的知识和技能,发展人的智力和体力,影响人的思想品德的社会活动,具有目的性和社会性。广义教育包括社会教育、家庭教育、学校教育。广义的教育是人类社会有史以来就有的教育活动。  \n狭义的教育就是指学校教育。  \n教育的要素:教育者、受教育者、教育影响(主要是教育内容)。",
    "id": 9
  }
}
{
  "id": 21,
  "distance": 0.7688303589820862,
  "entity": {
    "h2": "第二节 教育和社会的关系",
    "content": "### (六)生产力与教育的关系  \n生产力对其它一切因素都起着决定的作用,是决定教育性质的根本因素。  \n生产力对教育的主要作用表现为:生产力发展水平决定着教育事业发展的规模和速度;生产力发展水平制约着人才培养的规格与教育结构;生产力的发展促进教育内容、教学方法和教学组织形式的发展与改革。  \n教育对生产力的作用表现为:教育再生产劳动力;教育是科学知识与技术发展的重要手段。",
    "id": 21
  }
}
{
  "id": 10,
  "distance": 0.7677097320556641,
  "entity": {
    "h2": "第二节 教育的定义",
    "content": "### (二)教育的属性  \n教育的本质属性是有目的地培养人的社会活动。  \n教育的永恒性。  \n教育的历史性。  \n教育的相对独立性。  \n教育的长期性。  \n教育的生产性。  \n教育的民族性。",
    "id": 10
  }
}
{
  "id": 5,
  "distance": 0.7638531923294067,
  "entity": {
    "h2": "第一节 中外教育家及其教育思想",
    "content": "### (五)荀子主要思想  \n**人性论**:性恶论,化性起伪,善德是后天习得的,重视教育的作用。  \n**教学原则**:学以致用,锲而不舍。",
    "id": 5
  }
}
2.2.7.4.混合检索
正如前面所演示的,单一采用稀疏或稠密检索都会存在问题:
- 稀疏检索: 可以精确匹配专业名词,但会漏掉同义词或语义接近的内容
- 稠密检索: 擅长检索语义接近的内容,但可能错过专业名词,甚至错过关键词
所以,最佳的方案就是把两种方案结合,也就是混合检索。
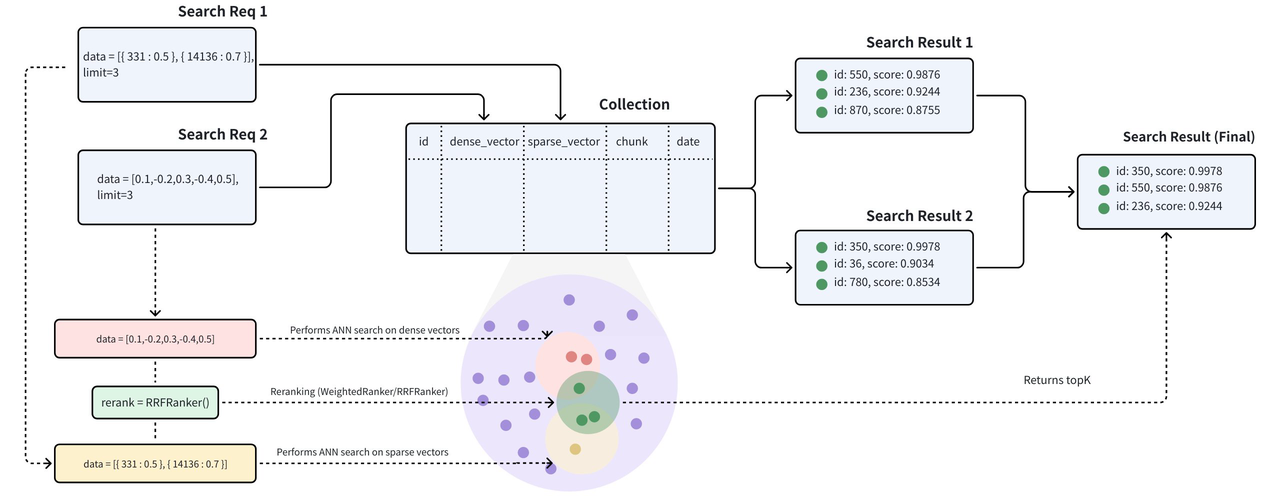
2.2.7.4.1.混合检索流程
混合检索流程是这样的:
- 多路召回:通过稀疏、稠密等多种方式分别查询文档列表,得到多个结果集
- 融合重排:再将所有文档融合为一个列表,重新打分排序
混合搜索结合了稠密、稀疏等方法,既能提供广泛的语义理解,又能提供精确的术语查询。混合搜索充分利用了每种方法的优势,克服了单独方法的局限性,为复杂查询提供了更好的性能。
但问题来了:
多路召回的文档结果,该如何融合重排呢?
常见的融合重排方式有:
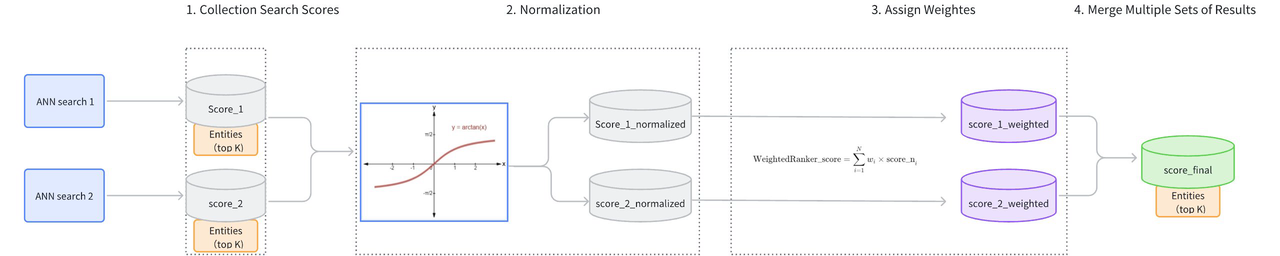
- 加权求和: 首先需要对分数归一化,然后给不同的召回方案设置不同权重,然后合并分数
- RRF:基于倒数排名求和,只与排名有关,与分数无关。公式:1/(k + rank)
- Cross-Encoder:利用神经网络模型,对多路结果做精排
2.2.7.4.2.加权融合
加权融合顾名思义,就是给多路召回的文档分配不同的权重,然后将文档在每一路中的打分加权求和,重新排序。
例如,我们设定稠密与稀疏的权重比例为:[0.6, 0.4],假设一篇文档得分如下:
- 稠密检索得分:0.5
- 稀疏检索得分:0.8
最终得分就是:
0.5 * 0.6 + 0.8 * 0.4 = 0.62
─┬─   ─┬─   ─┬─   ─┬─
 │     │     │     │
 │     │     │     └──稀疏权重
 │     │     └──稀疏得分
 │     │
 │     └─稠密权重
 └─ 稠密得分
不过,需要注意的是,由于不同的检索体系打分方式不同,分值差异可能较大:
| 检索器 | 分数范围 | 典型值 |
|---|---|---|
| BM25 | 通常 0 ~ 10+ | 0.5, 1.2, 5.0 |
| 向量余弦相似度 | 0 ~ 1(或 -1~1) | 0.85, 0.92 |
直接做加权求和没有意义,分数尺度大的检索器会主导结果。
通常,我们都会把分数归一化,使所有分数分布到特定范围,比如[0,1],常见的归一化方法有:
- Min-Max: 计算简单,值范围固定为
[0,1],为公式为(score - min) / (max - min) - Z-Score: 转为均值为0,标准差为1的正态分布。公式是
(s - avg) / 标准差 - Softmax: 将分数转为概率分布,所有值在 0~1 之间,且总和为 1,分布均匀程度取决于temperature。
整体流程如图:
Milvus默认支持混合检索,基本步骤如下:
- 创建多路请求,比如:稀疏、稠密
- 配置融合策略,比如:加权、RRF
- 发起请求
我们先定义一个混合检索函数,但融合重排策略作为参数传递:
from pymilvus import AnnSearchRequest


# 混合检索
def hybrid_search(query: str, ranker) -> list[list[dict]]:
    # 定义稠密向量检索请求
    query_vector = embeddings.embed_query(query)
    dense_request = AnnSearchRequest(
        data=[query_vector],
        anns_field='dense',
        param={"metric_type": "COSINE"},
        limit=3
    )

    # 定义稀疏向量检索请求
    sparse_request = AnnSearchRequest(
        data=[query],
        anns_field='sparse',
        param={"metric_type": "BM25"},
        limit=3
    )

    # 组合稠密和稀疏请求
    requests = [dense_request, sparse_request]

    # 调用客户端对象进行混合检索
    return client.hybrid_search(
        collection_name=collection_name,
        reqs=requests,
        ranker=ranker,
        limit=3,
        output_fields=['id', 'h2', 'content']
    )
然后使用Milvus提供好的权重融合策略:
import json
from pymilvus import WeightedRanker

# 测试混合检索-加权融合
# 创建排序器对象
ranker = WeightedRanker(0.6, 0.4)
# 调用函数执行混合检索
result = hybrid_search(query='教育的负面作用是什么', ranker=ranker)

for hits in result:
    for hit in hits:
        print(json.dumps(hit, indent=2, ensure_ascii=False))
2.2.7.4.3.RRF倒数排名融合
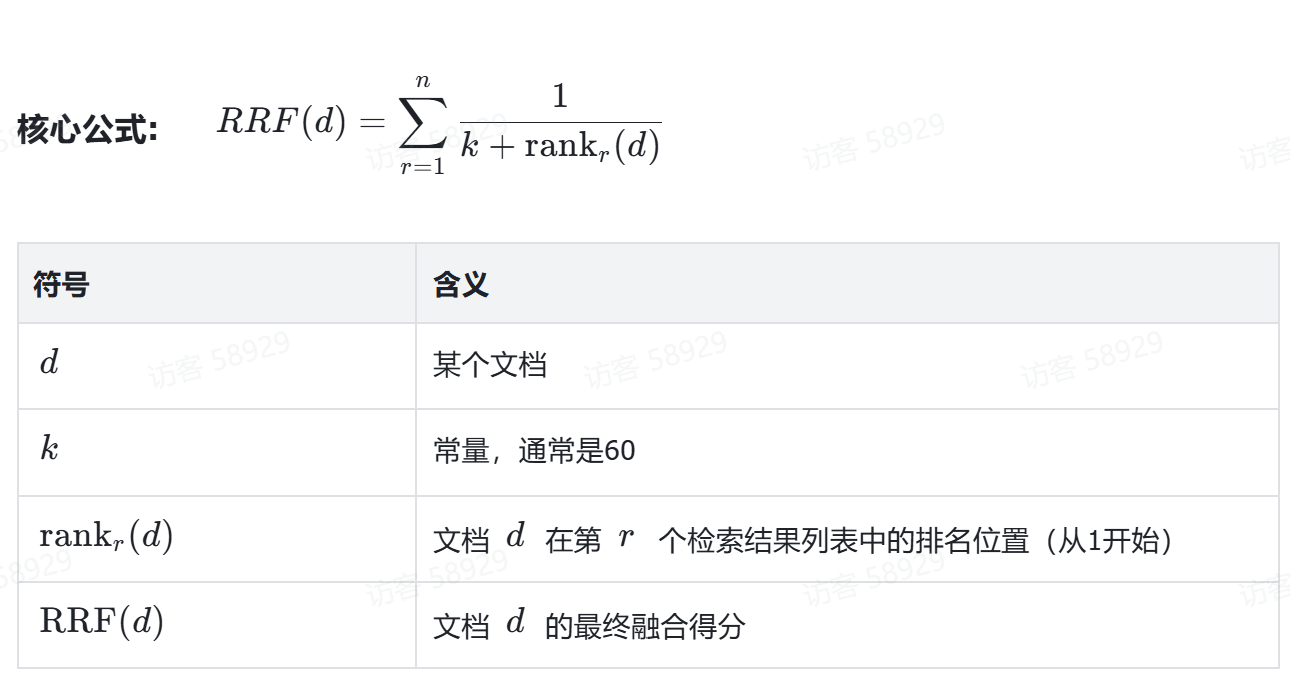
RRF(Reciprocal Rank Fusion,倒数排名融合) 是一种用于融合多个检索结果列表的算法,它与多路召回的文档得分无关,只关心排名。
| 稠密 | 稀疏 | |
|---|---|---|
| A | 1 | 6 |
| B | 4 | 3 |
核心公式如下:
RRF 的特点:
| 优点 | 缺点 |
|---|---|
| 无需归一化,因为与分数无关 | 对排名靠后的文档不敏感 |
| 对离群值不敏感 | 无法处理得分/置信度信息 |
| 计算简单、效率高 | |
| 可融合任意数量的检索列表 | 所有检索源权重相同 |
Milvus同样提供了默认的RRF融合策略,用法如下:
from pymilvus import AnnSearchRequest, RRFRanker

# 定义RRF融合策略
ranker = RRFRanker(k=60)
# 测试
hybrid_search("教育的负面作用是什么", ranker)
2.2.7.4.4.Cross-Encoder
特别提示
Cross-Encoder,交叉编码,把用户问题和每个文档一起输入模型,精确打分。
与之相对的是:Bi-Encoder, 并行编码,把用户问题、文档分别交给模型,转为向量,然后比较相似度。
Bi-Encoder由于是把文档和问题分开处理,所以可以把文档向量化放在离线阶段,存入向量库。检索时只需要把问题向量化,然后与文档向量比较即可。所以速度更快,能处理数以百万的文档,但精度略差,适合初筛。
Cross-Encoder需要实时把文档和问题一起计算,效率较低,但精度较高,适合精排。
我们之前所说的稀疏向量检索、稠密向量检索都属于是Bi-Encoder,相当于对文档做初步筛选。
筛选后的结果再交给专业的Cross-Encoder模型做精排,检索的结果会更加精准。
Cross-Encoder需要用专业的Reranker模型,比如:
| 模型名称 | 研发机构 | 发布时间 | 参数量 | 上下文长度 | 授权协议 | 核心亮点 |
|---|---|---|---|---|---|---|
| Qwen3-Reranker-4B | 阿里通义 | 2025-06 | 4B | 32k | Apache 2.0 | MMTEB-R 评分 72.74(高精度),支持32K长文本,中英文均衡适配,适合企业级高精度RAG |
| mxbai-rerank-large-v2 | MixedBread | 2025-07 | 1.5B | 8k | Apache 2.0 | BEIR 18项任务零样本SOTA,完美适配德/英/西/法等多语言场景,泛化性强 |
| bge-reranker-v2-m3 | BAAI | 2024-03 | 567M | 8k | Apache 2.0 | 中文社区主流选择,量化后体积<200MB,中英文混合场景表现突出,部署成本低 |
| jina-reranker-v3 | Jina AI | 202510 | 0.6B | 默认8k | CC-BY-NC-4.0(商用需授权) | 支持100+语言,专为Agentic-RAG场景微调,listwise交叉交互机制,适配多轮检索决策 |
| ms-marco-MiniLM-L6-v2 | Microsoft | 2021 | 22M | 512 | MIT | 超轻量架构,CPU/边缘端部署首选,英文通用场景标杆模型,推理速度快、集成成本低 |
| ColBERT v2 | CMU/Stanford | 2021-12 | 110M | 原生512 | MIT | 预编码+后期交互架构,百万级文档低延迟重排,吞吐较传统模型提升10倍,适合大规模英文知识库,长文本需分块处理 |
Milvus天然支持Cross-Encoder的重排序方案,不过由于Cross-Encoder方案依赖于Rerank模型,所以需要你有可访问的Rerank模型服务才行。
Milvus的Cross-Encoder重排实现流程是这样的:
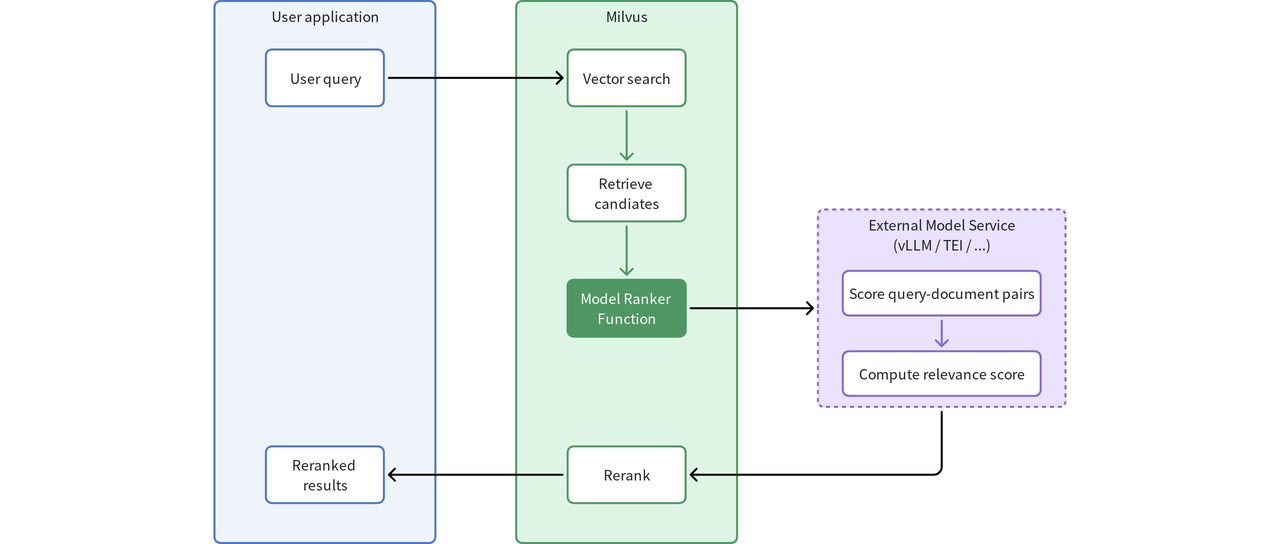
流程说明:
- 初始查询:您的应用向 Milvus 发送查询请求
- 向量检索:Milvus 执行标准向量检索(可以是混合检索模式),以识别候选文档
- 候选召回:系统根据向量相似度,初步筛选出一组候选文档
- 模型评估:Rerank模型(Model Ranker Function)对(query-document)对进行处理:
- 将Query和Document发送至外部模型服务
- Rerank模型评估Query与每个Document之间的语义相关性
- 每个Document基于语义理解获得一个相关性分数
- 智能重排:根据模型生成的相关性分数对文档重新排序
- 结果增强:您的应用收到的结果是按语义相关性排序的,而非仅依赖向量相似度
Milvus支持的外部模型有很多种,可以是自己部署的,也可以是云服务的:
| 提供商 | 最适合 | 特点 |
|---|---|---|
| vLLM | 需要深度语义理解和定制化的复杂应用 | 支持各种大型语言模型灵活的部署选项更高的计算要求更大的定制潜力 |
| TEI | 快速实施,资源利用率高 | 针对文本操作进行优化的轻量级服务部署更简便,资源需求更低预优化重新排序模型基础设施开销极低 |
| Cohere | 优先考虑可靠性和集成便捷性的企业级应用 | 企业级可靠性和可扩展性无需基础设施维护的托管服务多语言重新排序功能内置速率限制和错误处理 |
| Voyage AI | 具有特定性能和上下文要求的RAG应用 | 专门针对重新排序任务训练的模型针对不同文档长度的精细截断控制针对生产环境工作负载优化的推理多种模型变体(rerank-2、rerank-lite 等) |
| SiliconFlow | 优先考虑成本效益的長文档处理应用 | 支持可配置重叠度的先进文档分块技术基于片段的评分支持多种重新排序模型提供标准版和专业版两种模型,性价比高 |
| DashScope | 使用阿里云或Qwen重新排序模型的应用程序Milvus 3.x版本才支持 | 托管式 DashScope 重新排序 API支持以下重新排序模型:gte-rerank-v2基于 API 密钥的身份验证 |
| Hugging Face | 使用托管版 Hugging Face 句子相似度模型的应用程序 | 使用托管版hf-inference 提供商从 Hugging Face Hub 中选择模型为每个候选项计算一个句子相似度分数使用 API 密钥进行身份验证 |
请注意!!!
DashScope的重排方案仅在Milvus3.0.x的版本才开始才支持,如果是小于这个版本,建议在企业中使用vLLM部署私有模型。
下面,我们以DashScope为例来说明这种重排方案的用法。
1.配置秘钥
不管使用哪种模型提供商,都需要在Milvus服务中配置授权密钥,也就是API_KEY.
找到虚拟机中的deploy/milvus/user.yaml文件,将其中的credential.dashscope_apikey.apikey改成你自己的DashScope的API_KEY:
credential:
  dashscope_apikey:
    apikey: sk-xxxxxxx
然后重新启动milvus:
cd /root/deploy

docker compose restart milvus2.定义RerankFunction
接着,我们回到Notebook,定义一个Cross-Encoder的Function:
# cross-encoder rerank
from pymilvus import Function, FunctionType


def create_cross_encoder_ranker(queries: list[str]):
    return Function(
        name="dashscope_semantic_ranker",      # ranker名词,唯一即可
        input_field_names=["content"],          # 原始文档字段
        function_type=FunctionType.RERANK,  # ranker类型,这里是固定值
        params={
            "reranker": "model",  # rerank类型,基于模型rerank,也就是cross-encoder
            "provider": "ali",  # rerank模型提供者
            "model_name": "gte-rerank-v2",  # rerank模型名称
            "queries": queries,  # 查询条件
            "max_client_batch_size": 5,  # 单批次中处理的文档最大数量
        },
    )
这段代码是通用的代码,将来你的模型提供商会变化,但这段代码基本不变。
提示
Milvus中Cross-Encoder这种策略的Function定义是固定代码,变化的仅仅是模型的提供商、模型的名称。核心代码参数是这样的:
name:ranker名词,自定义,但要唯一input_field_names:用来存放原始文档的字段params:ranker的核心参数reranker:rerank类型,支持model、rrf、weight等,model就是cross-encoder模式provider:模型的提供商,就是上面说的几个model_name:rerank模型名称queries: 查询条件max_client_batch_size:单批次中处理的文档最大数量
3.基于Cross-Encoder的混合检索
最后,沿用之前的混合检索函数,传递create_cross_encoder_ranker即可:
def cross_encoder_hybrid_search(query):
    # 创建排序器对象
    ranker = create_cross_encoder_ranker([query])
    # 调用混合检索的方法完成混合检索
    return hybrid_search(query=query, ranker=ranker)
测试代码如下:
import json

# 测试cross_encoder融合
result = cross_encoder_hybrid_search("教育的负面作用是什么")
for hits in result:
    for hit in hits:
        print(json.dumps(hit, indent=2, ensure_ascii=False))
{
  "id": 15,
  "distance": 0.29470494389533997,
  "entity": {
    "h2": "第一节 教育的功能",
    "content": "# 第二章 教育基本原理  \n## 第一节 教育的功能  \n### (一)个体发展功能和社会发展功能  \n教育的正向功能(积极功能)指教育有助于社会进步和个体发展的积极影响和作用。  \n教育的负向功能(消极功能)指阻碍社会进步和个体发展的消极影响和作用。  \n教育的显性功能是指教育活动依照教育目的,在实际运行中所出现的与之相吻合的结果。  \n教育的隐性功能指伴随显性功能所出现的非预期性的功能。",
    "id": 15
  }
}
{
  "id": 20,
  "distance": 0.146241694688797,
  "entity": {
    "h2": "第二节 教育和社会的关系",
    "content": "### (五)人口与教育的关系  \n人口对教育的作用主要表现在:人口的数量和增长是决定教育事业的规模、速度的一个重要因素;人口的质量影响教育的质量;人口的结构影响着教育的发展;人口流动影响着教育的发展。  \n教育对人口的作用主要表现在:控制人口的数量;提高人口的质量;改善人口结构;调整人才构成与流动等作用。",
    "id": 20
  }
}
{
  "id": 21,
  "distance": 0.13745088875293732,
  "entity": {
    "h2": "第二节 教育和社会的关系",
    "content": "### (六)生产力与教育的关系  \n生产力对其它一切因素都起着决定的作用,是决定教育性质的根本因素。  \n生产力对教育的主要作用表现为:生产力发展水平决定着教育事业发展的规模和速度;生产力发展水平制约着人才培养的规格与教育结构;生产力的发展促进教育内容、教学方法和教学组织形式的发展与改革。  \n教育对生产力的作用表现为:教育再生产劳动力;教育是科学知识与技术发展的重要手段。",
    "id": 21
  }
}
2.2.7.5.过滤
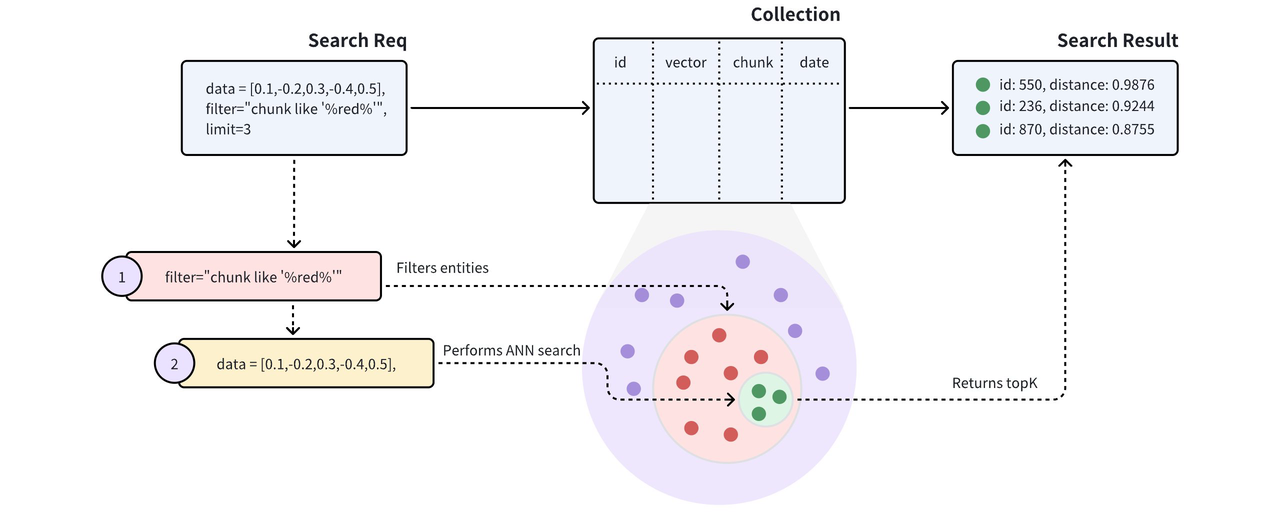
除了向量搜索,Milvus也支持普通字段过滤。Milvus 收到携带过滤条件的搜索请求后,会将搜索范围限制在符合指定过滤条件的实体内,再进行向量检索,从而提高查询效率。
如图:
Milvus中的混合检索条件就是一个普通字符串,其语法与MySQL的where条件几乎一样:
filter = 'id == 1'

filter = 'id >= 1'

filter = 'title like "%重疾险%"'

filter = 'id in [11, 20, 30]'具体语法参考官方文档:https://milvus.io/docs/zh/basic-operators.md
代码示例如下:
# RRF 混合检索
from pymilvus import AnnSearchRequest

def hybrid_search(query: str, ranker, filter_query: str = None):
    # 1.创建稠密、稀疏请求
    # 稠密
    query_dense_vector = embeddings.embed_query(query)
    dense_request = AnnSearchRequest(
        data=[query_dense_vector],
        anns_field="dense",
        param={"metric_type": "COSINE"},
        limit=3,
        filter=filter_query
    )
    # 稀疏
    sparse_request = AnnSearchRequest(
        data=[query],
        anns_field="sparse",
        param={"metric_type": "BM25"},
        limit=3,
        filter=filter_query
    )
    # 混合在一起
    reqs = [dense_request, sparse_request]

    # 2.设定融合策略,发送请求
    res = client.hybrid_search(
        collection_name=collection_name,
        reqs=reqs,
        ranker=ranker,
        limit=2,
        output_fields=['content', 'h2']
    )
    for hits in res:
        print("TopK results:")
        for hit in hits:
            print(hit)


from pymilvus import WeightedRanker

# 定义加权融合策略
ranker = WeightedRanker(0.5, 0.5)
# 测试
hybrid_search("教育的负面作用是什么", ranker, filter_query="h2 == '第一节 教育的功能'")
3.LangChain-Milvus
在之前我们都是使用Milvus的官方客户端,它的功能更全面,可以支持灵活定制,但使用起来有点麻烦
比较适合于需要各种定制化功能的场景
其实LangChain也是支持Milvus的,相比官方的客户端,LangChain功能有一定的限制,比如:
- 混合检索仅支持稀疏+稠密两种模式
- 不支持多模态向量检索
- 不支持对普通字段加索引
不过,这对于大多数的场景已经够用了。接下来我们就来学习LangChain的Milvus客户端。
3.1.准备工作
先安装依赖:
uv add langchain-milvus准备文档切分工具:
# 一、准备文档
from langchain_text_splitters import MarkdownHeaderTextSplitter


def prepare_docs():
    # =============1.准备文档================
    with open('./resources/评估.md', 'r', encoding='utf-8') as f:
        doc = f.read()

    # =============2.切分文档================
    # 切分依据,这里是按照三级标题
    headers_to_split_on = [
        ("#", "h1"),
        ("##", "h2"),
        ("###", "h3"),
    ]

    # 创建切分器
    markdown_splitter = MarkdownHeaderTextSplitter(
        headers_to_split_on,
        strip_headers=False  # 在正文中是否去除标题,False,不去除
    )

    # 切分文档, 返回的是 list[Document]
    docs = markdown_splitter.split_text(doc)

    # 为了方便查看,给每个Document加一个id,从1开始递增,但要注意的是LangChain的文档id要求是str
    for i, doc in enumerate(docs, start=1):
        doc.id = str(i)
    return docs

docs = prepare_docs()
特别注意!!!
- LangChain写入Milvus的文档如果自定义ID,则ID必须是字符串类型!
- 也可以不指定ID,则ID由Milvus生成,为INT64类型
准备向量模型
与之前类似,我们还是使用Ollama的向量模型:
# 二、初始化向量模型
from langchain_ollama import OllamaEmbeddings

# 1.初始化向量模型
embeddings = OllamaEmbeddings(
    model="qwen3-embedding:0.6b",  # 性价比高的模型
    dimensions=1024  # 可选:减少维度以节省存储
)
如果本地Ollama使用不了,可以使用阿里云向量模型
from pydantic import SecretStr
from langchain_openai import OpenAIEmbeddings
import os
from dotenv import load_dotenv

load_dotenv() # 加载环境变量

dashscope_base_url = os.getenv('DASHSCOPE_BASE_URL')
dashscope_api_key = os.getenv('DASHSCOPE_API_KEY', '')

# 使用openai规范连接阿里云平台使用其嵌入模型
embeddings = OpenAIEmbeddings(
    base_url=dashscope_base_url,
    api_key=SecretStr(dashscope_api_key),
    model='qwen3.7-text-embedding',
    check_embedding_ctx_length=False  # 取消向量长度检查
)
3.2.VectorStore
LangChain中的操作是基于VectorStore的,当我们初始化VectorStore时,它可以自动帮我完成下列事情:
- 自动根据
Document中的数据生成schema,有一些固定的字段:pk:也就是主键,如果你提供了id,就用你的id值,没有的话会由Milvus自动生成text:就是原始文本字段,存储的是Document的page_content值向量字段:会根据text值自动生成稠密和稀疏向量,名字可自定义普通字段:Document的metadata会被展开,其中的每个字段都会成为Collection中的一个字段
- 自动给向量字段加索引,但其它字段不会有索引
- 初始化Collection
- 批量导入文档,也就是Entity
3.2.1.初始化VectorStore
# 三、初始化Collection,或者叫VectorStore
from langchain_milvus import Milvus, BM25BuiltInFunction
from app.core.config import settings

vector_store = Milvus(
    embedding_function=embeddings,  # 稠密向量模型
    collection_name="langchain_collection",  # collection名称
    builtin_function=BM25BuiltInFunction(  # 生成稀疏向量的函数
        analyzer_params={"type": "chinese"}  # 指定中文分词
    ),
    vector_field=["dense", "sparse"],  # 向量字段,包括稠密和稀疏
    connection_args={
        "uri": settings.rag.milvus_url,  # milvus的uri路径
    },
    drop_old=True,  # 是否删除旧的collection,避免重复创建
)
3.2.2.批量新增
新增调用add_documents()直接 传入list[Document]即可,LangChain会自动根据Document生成Schema、Index、Collection,完全不用我们操心。
# 添加文档
batch_documents = [docs[i:i + 20] for i in range(0, len(docs), 20)]

for batch in batch_documents:
    result = vector_store.add_documents(documents=batch)
    print(result)
3.2.3.支持基于id的删除:
# 演示删除文档
vector_store.delete([468847736313318163])  # type:ignore
3.3.检索
LangChain-Milvus实现了VectorStore接口,所以用法与前面讲的VectorStore基本一样,并且也支持混合检索和融合策略了。
我们以similarity_search_with_score为例,它接收参数:
query:查询条件k:查询文档数量ranker_type:重排策略,目前只支持weighted、rrf两个值ranker_params:重排参数,ranker_type不同,传入值也不同weighted:传入{"weights": [0.4, 0.6]}rrf:传入{"k": 60}
请注意
一旦你的Collection设定了稀疏向量,LangChain默认会自动开启加权混合检索,必须传入混合检索参数,否则会报错。
3.3.1.基于权重的混合检索
# 测试混合检索
result = vector_store.similarity_search_with_score(
    query='教育的负面作用是什么',
    k=3,
    fetch_k=5,  # 初筛时召回的文档的数量
    ranker_type='weighted',
    ranker_params={'weights': [0.5, 0.5]}
)

for document, score in result:
    print(f'=================文档得分:{score}======================')
    print(f'文档内容:{document.model_dump_json(indent=2)}')
3.3.2.基于RRF的混合检索
# 测试混合检索
result = vector_store.similarity_search_with_score(
    query='教育的负面作用是什么',
    k=3,
    fetch_k=5,     # 初筛时召回的文档的数量
    ranker_type='rrf',
    ranker_params={'k': 60}
)

for document, score in result:
    print(f'=================文档得分:{score}======================')
    print(f'文档内容:{document.model_dump_json(indent=2)}')
3.3.3.过滤搜索
LangChain是支持过滤检索的,表达式与Milvus一样:
# 测试混合检索
result = vector_store.similarity_search_with_score(
    query='教育的负面作用是什么',
    k=5,
    fetch_k=5,
    ranker_type='rrf',
    ranker_params={'k': 60},
    expr='h2 like "%第一节%"'  # 过滤条件
)

for document, score in result:
    print(f'=================文档得分:{score}======================')
    print(f'文档内容:{document.model_dump_json(indent=2)}')
3.3.4.基于Cross-Encoder的混合检索
rrf和加权是LangChain默认支持的重排方案,因此可以用ranker_type直接指定。
但LangChain是不支持Cross-Encoder混合检索的,此时不能用ranker_type了,而是直接传递一个自定义的reranker.
例如,我们要使用DashScope的重排模型,这么做:
- 先定义生成ranker的函数
def create_cross_encoder_ranker(queries: list[str]):
    return Function(
        name="dashscope_semantic_ranker",  # ranker名词,唯一即可
        input_field_names=["text"],  # 原始文档字段
        function_type=FunctionType.RERANK,  # ranker类型,这里是固定值
        params={
            "reranker": "model",  # rerank类型,基于模型rerank,也就是cross-encoder
            "provider": "ali",  # rerank模型提供者
            "model_name": "gte-rerank-v2",  # rerank模型名称
            "queries": queries,  # 查询条件
            "max_client_batch_size": 5,  # 向模型发送请求时的批处理限制
        },
)- 再定义混合检索函数:
def cross_encoder_hybrid_search(query: str, filter: str = ""):
    # 1.混合搜索
    return  vectorstore.similarity_search_with_score(
        query,
        k=3,            # 最终返回的TopK
        fetch_k=5,      # 初筛时召回的文档的数量
        expr=filter,
        reranker=create_cross_encoder_ranker([query])
    )
测试代码:
query = "教育的负面作用是什么"
result = cross_encoder_hybrid_search(query, 'h2 like "%教育的功能%"')

for document, score in result:
    print(f'文档得分:{score}')
    print(f'文档内容:{document.model_dump_json(indent=2)}')