1.认识RAG
大型语言模型(LLM)功能确实强大,但是在我们日常使用的过程中,我们会了解到几个关键局限性:
- 知识局限性:模型的回答都来自于训练数据,对于完全未接触过的专业领域,无法给出正确的答案
- 时间局限性:模型训练数据都来自于历史数据,比如:DeepSeek的训练数据截止于2026年2月,无法回答实时问题
举个例子:某保险公司开发了一个自己的智能客服,希望智能客服可以7*24小时在线,回答用户与自家的保险产品、条款、理赔有关的问题。
但是,受限于知识局限性,LLM对这家保险公司的产品、理赔条款完全不知道,是没办法回答的。如果强行回答,只能说一本正经的胡说八道,这样就会产生幻觉。
详解一下RAG(Retrieval-Augmented Generation)中的每一个单词:
检索:就是利用向量相似度检索知识片段
增强:用检索到的知识片段增强模型,减少幻觉
生成:模型基于知识片段生成答案
RAG核心流程
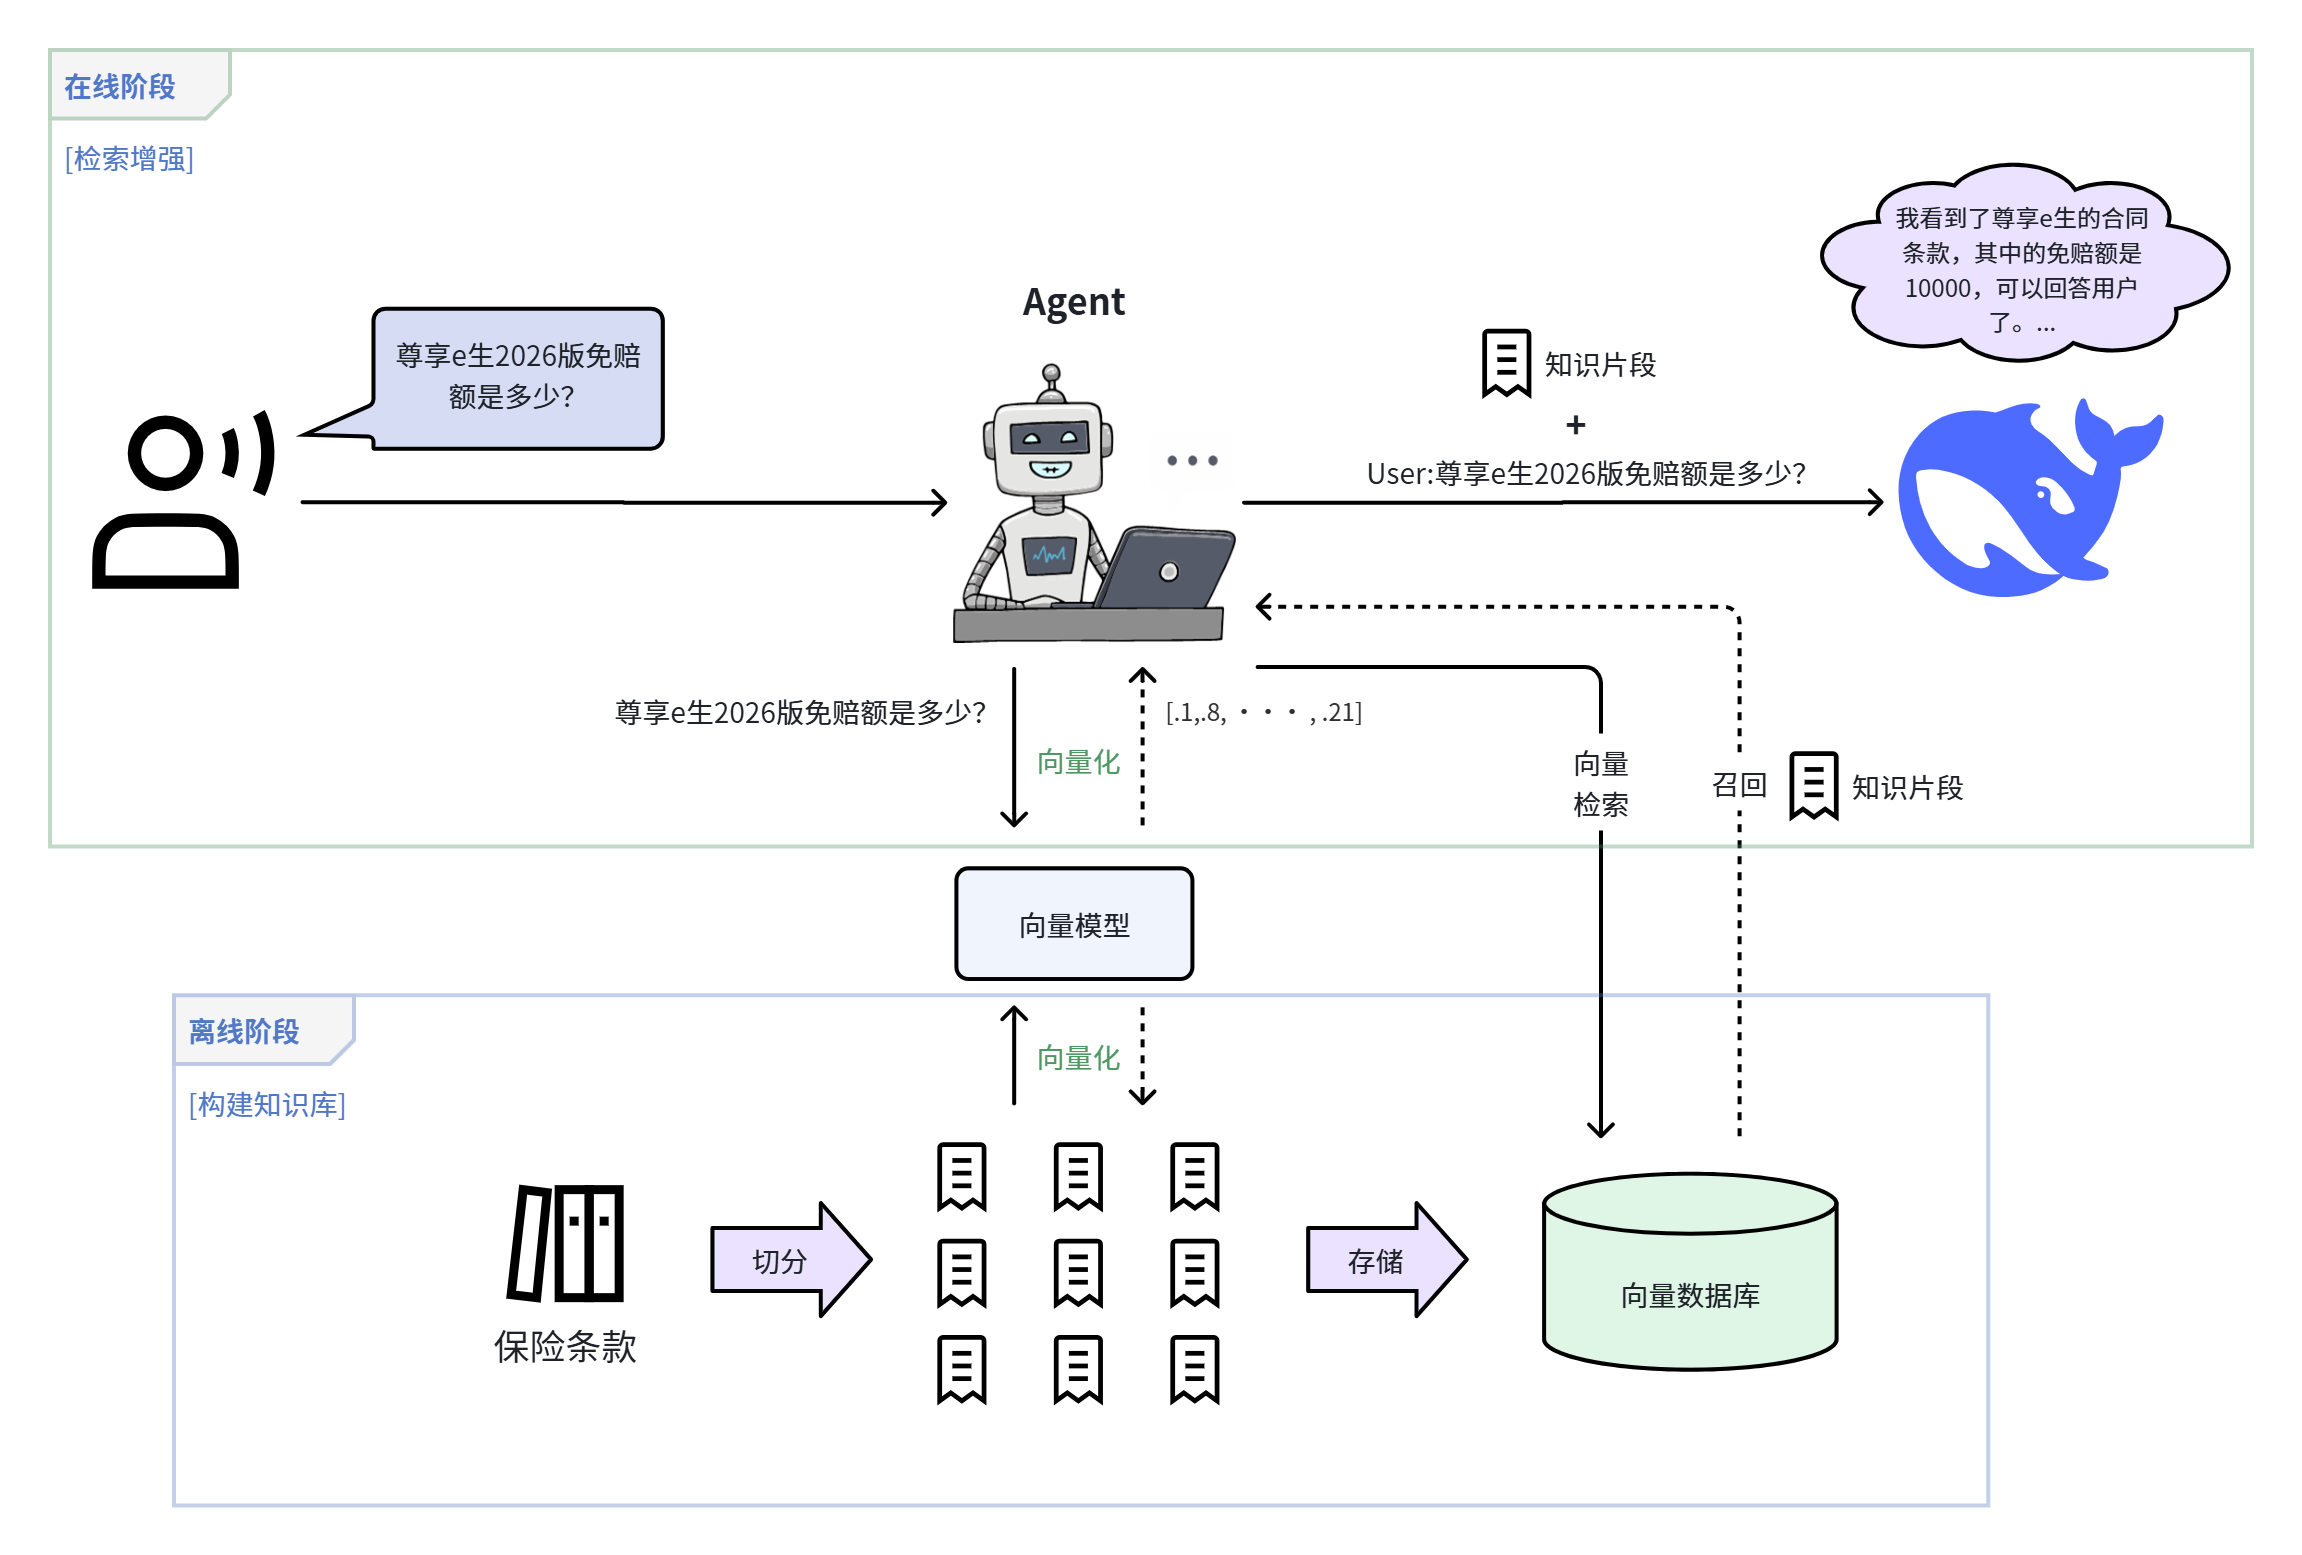
RAG分为两大阶段:
- 离线阶段:负责构建知识库
- 知识加载:读取各种来源的知识库数据,解析、清洗数据,形成文档(Documents)。
- 知识切分:把清洗后的知识文档切分成一个个的知识片段(Chunks)
- 向量化:利用向量模型将知识片段转为向量,使得语义相近的文本在该向量空间中彼此邻近
- 存储向量:将处理好的向量及对应的知识片段存入向量数据库
- 在线阶段:负责检索知识,生成回答
- 问题向量化:利用向量模型(必须与离线阶段同一个模型)将用户问题转为向量
- 知识召回:在向量数据库中检索与问题向量最相似的文档的TopN
- 生成回答:把检索到的知识片段与用户提问组织为新提示词,发给大模型,生成回答
2.构建知识库
2.1.文档加载
2.1.1.BaseLoader和Document
LangChain提供的所有加载器都继承了BaseLoader,部分源码如下。
class BaseLoader(ABC):  # noqa: B024
    """Interface for document loader. """

    def load(self) -> list[Document]:
        """Load data into `Document` objects.

        Returns:
            The documents.
        """
        return list(self.lazy_load())

# ... 略因此,所有的文档加载器都具有通用的文档加载方法**load()** : 一次性加载所有文档
可以看到,**load()**方法加载数据后返回的是一个列表,其中每一个元素是 Document 对象,它是LangChain中用来表示文档片段的对象,包含两个核心字段。
page_content: 文档内容metadata: 元数据(如来源、页码等)
下面,我们以PDF文档加载为例,看看LangChain的Document Loader如何使用。
2.1.2.PyPDFLoader
PyPDFLoader是加载PDF文件的加载器,依赖于pypdf,在LangChain的Community社区对其提供了支持,包含两个核心字段。
- file_path:代表要加载的PDF文件的路径,支持绝对路径和相对路径
- mode:代表加载模式,支持两种模式
single:整个文档作为一个Document,但是可以自定义文档页与页之间的分隔符,推荐page:每页作为一个Document
它可以把PDF加载为多种格式:json、markdown、html、纯文本等。
使用它加载PDF文件,只需要两个步骤:
- 创建文档加载器
- 调用**load()**方法,将文件加载为Document列表
安装对应的依赖:
uv add langchain-community pypdf使用PyPDFLoader加载PDF文件。
from langchain_community.document_loaders import PyPDFLoader

# 初始化并配置文档加载器
loader = PyPDFLoader(
    file_path='resources/测试的文件.pdf',
    mode="page" # single: 整个文件作为1页文档. page:按PDF分页
)

# 加载PDF文件,得到list[Document]
docs = loader.load()
print(f'文档数量:{len(docs)}')

# 遍历,得到每一个Document,都包含page_content和metadata两个属性
for i, doc in enumerate(docs, start=1):
    print(f"==============Doc_{i}=================")
    print("metadata = ", doc.metadata)
print("page_content = ", doc.page_content)pypdf处理复杂的PDF有局限性,会发现整篇文档格式混乱,毫无格式可言,需要使用更加强大的工具来处理复杂的PDF文件。
特别注意
langchain-community不再被langchain官方维护,使用过程中会警告,也不再推荐使用,这里只做演示,不做推荐。
2.1.3.MinerU
某些行业的PDF文件结构非常复杂,可能包含:左右分栏、复杂表格、图文混排、图片扫描件等情况。针对这样的PDF文件就需要用到诸如:文档结构识别模型、多模态模型、表格处理、OCR等专用工具,非常复杂,仅仅使用LangChain默认的PDF加载工具就不行了。好在市面上已经有很多专业的工具,帮我们实现了这些功能。此处我们就以MinerU为例,来加载复杂PDF文件。
MinerU的公共API服务提供两种模式:
- 🎯 精准解析 API — 需申请 Token,支持单文件/批量、表格/公式/多格式输出,限制页数<=200
- ⚡ Agent 轻量解析 API — 免登录,IP 限频防滥用,专为 AI Agent 工作流设计,限制页数<=20
如果要使用精准解析模式,就必须注册账号,开通API Token,不过不用担心,并不需要收费~嘿嘿。
MinerU的API是基于HTTP协议,理论上我们可以直接基于HTTP请求调用,不过太麻烦了,所以,MinerU官方提供了多种不同的访问API接口的方式,例如:
- 基于Skills和MCP
- 基于CLI
- 基于SDK,支持Python、JS、TS、GO
- 基于RAG框架,支持LangChain、Dify、RAGFlow、LlamaIndex等
详见官方文档:MinerU 生态
重点说两种:
- SDK : 原生SDK,兼容性最好,可以自由的处理MinerU解析好的markdown、images、json
- LangChain : 完美适配LangChain,但解析PDF时只能得到markdown,其它内容无法获取
官方提供的SDK更加灵活,这里我们学习官方SDK的用法。
先安装依赖:
uv add mineru-open-sdk2.1.3.1.轻量解析模式
- 创建MinerU客户端,无需Token
- 调用
flash_extract(),加载指定文档,得到一个返回值 - 从返回值中解析markdown格式的文件内容,支持保存到本地
from mineru import MinerU

# 创建客户端,Flash 模式,无需Token
client = MinerU()
# 解析文件
result = client.flash_extract("./resources/sample.pdf")

# 获取markdown
print(result.markdown)
# 保存到本地
result.save_markdown("./resources/r2.md")
2.1.3.2精准解析模式
- 创建MinerU客户端,需要Token
- 调用
extract(),加载指定文档,得到一个返回值 - 从返回值中解析markdown格式的文件内容
from mineru import MinerU
from app.core.config import settings

# 创建客户端,Precision 模式,需要Token
client = MinerU(settings.rag.mineru_token)
# 解析文件
result = client.extract("./resources/sample.pdf")

# 获取markdown
print(result.markdown)
# 输出到本地
result.save_markdown("./resources/r3.md", with_images=True)
2.1.3.3.OCR功能
对于扫描件类型的PDF,MinerU处理起来也毫不费力,只需要把extract()方法的OCR参数改为True即可。
from mineru import MinerU
from app.core.config import settings

# 创建客户端,Precision 模式,需要Token
client = MinerU(settings.rag.mineru_token)
# 解析文件,支持各种自定义参数,例如:ocr、
result = client.extract('./resources/small_ocr.pdf', ocr=True)

# 获取markdown
print(result.markdown)
# 输出到本地
result.save_markdown('./resources/output/r4.md')
MinerU不仅处理PDF是一把好手,它也能处理Html、ppt、pptx、doc、docx、xls、xlsx、图片等多种格式,理论上有这一种加载器就能满足99%的企业需求了。
2.2.文本切分
我们现在已经将文本从文件中加载出来了,但是LLM的上下文窗口有限,所以不能将加载的整个文档扔进去,需要将文档切分成合适大小的块(chunk)。
但是到底该切多大呢?
在这儿, 不能随意切分,我们要考虑两点因素:
- 检索精准度:能精准找到与问题最相关的chunk(知识片段)
- 语义完整度:检索到的chunk必须能覆盖回答用户问题的所有信息
而这两点是矛盾的,RAG是根据整个知识片段的语义生成一个向量,
- chunk越大,噪音越多,语义越不精准,检索精度就低;但同时语义完整度就越高
- chunk越小,噪音越少,语义越精准,检索精度就高;但同时语义完整度就越低
总结一下:
- 太大: 包含过多无关信息,检索精度下降
- 太小: 丢失上下文,语义不完整
那么,该如何切分出合适大小的知识片段呢?
常见的文档切分策略如下。
| 策略名称 | 核心原理 | ✅ 优点 | ❌ 缺点 | 适用场景 |
|---|---|---|---|---|
| 固定长度切分 | 按预设字符数或Token数切分 | 实现简单,速度快,可预测。 | 易在句子中间截断,严重破坏语义完整性。或者出现超大块。 | 日志、代码等结构不敏感文本;或作为性能基线。 |
| 递归切分 | 按优先级分隔符(如段落\n\n > 句子。)逐级递归分割,直至满足大小要求。 | 尊重文档结构,语义完整性好,能动态调整。 | 对无标准分隔符的文本效果下降。 | 通用首选,适用于报告、文章等大多数规范文档。 |
| 语义切分 | 用嵌入模型计算相邻句子相似度,在低于阈值时切分,识别主题转折点。 | 最大限度保持语义连贯性,分块质量高。 | 计算成本高,依赖嵌入模型精度。 | 对语义完整性要求极高的场景,如学术论文、法律文件。 |
| 结构感知切分 | 利用文档元数据(如Markdown/HTML标题)识别逻辑区块进行切分。 | 天然符合文档组织逻辑,结构清晰准确。 | 需要格式良好的文档,灵活性受限。 | Markdown、网页等有清晰原生结构的文档。 |
| 滑动窗口切分 | 固定窗口,通过高重叠率(如20%)滑动生成连续分块,保留上下文。 | 上下文连接紧密,避免信息断裂。 | 冗余度高,存储和计算开销大。 | 一般结合其他策略一块使用。 |
LangChain对常见的切分策略都有支持,接下来我们就来学习这些切分策略。
2.2.1.TextSplitter接口
安装langchain-text-splitters依赖。
uv add langchain-text-splittersLangChain中提供了各种不同的切分策略,并且提供了统一的接口:TextSplitter,其中最常用的两个函数:
split_text:接收普通文本,返回的是切分好的文本列表split_documents:接收的是Document列表,返回的是切分后的Document列表
LangChain中大部分的切分器都实现了TextSplitter接口,提供了这两个方法,虽然切分规则不同,但用法是大同小异。
其部分源码如下。
class TextSplitter(BaseDocumentTransformer, ABC):

    @abstractmethod
    def split_text(self, text: str) -> list[str]:
        """ Split text.
        Args:
            text: The text to split.

        Returns:
            A list of text chunks.
        """

    def split_documents(self, documents: Iterable[Document]) -> list[Document]:
        """Split documents.
        Args:
            documents: The documents to split.

        Returns:
            A list of split documents.
        """
        # ... 略
2.2.2.固定长度切分(不推荐)
先看最简单的一种,就是固定长度切分,在LangChain里提供了两个实现:
- 根据字符大小切分
- 根据字节大小切分
不管哪种都需要用到CharacterTextSplitter这个类。
2.2.2.1.CharacterTextSplitter - 按字符切分
最简单的切分方式,属于固定长度切分策略的一种,常见的三个参数:
separator: 分隔符,以此作为分隔的基本单元chunk_size: 每一块的理想大小chunk_overlap: 下一块与上一块重叠的大小,也就是滑动窗口切分
基于**CharacterTextSplitter执行文本切分操作,在这儿既然提供的一个较长的字符串**,可以使用**split_text**将长文本切分为文本片段。
# 准备一段较长的文本
doc = """
大型语言模型是近年来人工智能领域最令人瞩目的突破性技术之一。GPT-3、GPT-4、BERT、T5等模型的出现,彻底改变了自然语言处理领域的研究范式。

这些模型基于深度学习架构,通过在海量文本数据上进行预训练,学习到了丰富的语言知识和世界知识。

检索增强生成是近年来兴起的一种重要技术范式,它通过将大型语言模型与外部知识检索系统相结合,有效解决了模型知识更新困难、事实性错误、缺乏专业领域知识等问题。在这种范式中,当用户提出一个问题时,系统首先从外部知识库中检索相关的文档片段,然后将这些片段与用户问题一起作为输入传递给大型语言模型进行答案生成。这种方法不仅提高了模型回答的准确性,还增强了模型的可解释性和可控性。文本分割是构建检索增强生成系统的关键预处理步骤,因为检索的对象通常是文本片段,而分割的质量直接影响后续检索的精确度和召回率。如果分割策略不合理,会带来一系列严重的问题,比如当分割过于粗粒度时检索到的内容可能包含大量无关信息,当分割过于细粒度时则可能丢失关键的上下文信息。

LangChain提供了多种文本分割器实现。CharacterTextSplitter使用指定的单个分隔符对文本进行分割,实现简单高效。RecursiveCharacterTextSplitter则持有一个分隔符优先级列表,能够递归地尝试不同粒度的分隔符。这个分割器因此在处理结构复杂、格式多样的文本时表现更佳,也是LangChain官方推荐的默认分割器。在实际的工程实践中,选择合适的文本分割策略需要综合考虑文本本身的特征和下游任务的具体需求。

通过合理的实验设计和评估,开发者可以找到最适合特定场景的分割策略。
"""
from langchain_text_splitters import CharacterTextSplitter

# 创建字符切分器
text_splitter = CharacterTextSplitter(
    separator="",        # 分隔符,空就是任意位置都可分隔
    chunk_size=200,     # 每块最大200字符
    chunk_overlap=40,   # 块之间重叠40字符
)

# 切分文本
chunks = text_splitter.split_text(doc)

print(f"原始文本长度: {len(doc)} 字符")
print(f"切分为 {len(chunks)} 个块:\n")
for i, chunk in enumerate(chunks):
    print(f"--- Chunk {i+1} ({len(chunk)}字符) ---")
    print(chunk)
    print()
2.2.2.2.CharacterTextSplitter - 按Token切分
使用OpenAI开源的tiktoken计算token数量,按token数量切分,更精确地控制发送给LLM的token数。
from langchain_text_splitters import CharacterTextSplitter

# 创建字符切分器
# 使用from_tiktoken_encoder,LangChain自带,无需额外安装tiktoken
token_splitter = CharacterTextSplitter.from_tiktoken_encoder(
    encoding_name="cl100k_base",    # token分词器编码名
    chunk_size=200,                # 每块最多200 token
    chunk_overlap=40,              # 块之间重叠40 token
)

chunks = token_splitter.split_text(doc)

print(f"原始文本长度: {len(doc)} 字符")
print(f"切分为 {len(chunks)} 个块:\n")
for i, chunk in enumerate(chunks):
    print(f"--- Chunk {i+1} ({len(chunk)}字符) ---")
    print(chunk)
    print()
2.2.3.递归字符切分(推荐)
LangChain中提供了一个RecursiveCharacterTextSplitter类,是LangChain推荐的通用文本切分器,在不超过目标块大小的前提下,能够尽可能保持段落和句子的完整性,实现了递归字符切分,关键参数如下。
| 参数 | 作用 | 默认值 (通常情况) |
|---|---|---|
chunk_size | 目标块大小 (以字符/token计)。分割器努力让每个块的文本长度不超过这个值。 | 4000 |
chunk_overlap | 块间重叠长度。为了让块与块之间保留一些共同上下文,避免在关键信息处被切断。 | 200 |
separators | 自定义分隔符优先级列表。这是控制分割行为的核心,你可以根据文档格式(如代码、Markdown)调整顺序。 | ["\n\n", "\n", "。", ""] |
length_function | 长度计算函数。决定用何种方式测量文本长度(例如 len 计字符数,或 tiktoken 计token数)。 | len |
提示
其切分流程如下。
- 输入
- 原始长文本
T - 目标块大小
size - 一个有序的字符列表
separators(例如:["\n\n", "\n", "。", " ", ""],优先级从高到低)。
- 原始长文本
- 第一步(用最高级分隔符尝试):使用当前优先级最高的分隔符(例如段落分隔符
\n\n)尝试将T分割成若干块。 - 检查与判断:
- 遍历刚分割出的每一个块。
- 如果这个块的长度小于等于
chunk_size,则将其保留为一个最终的文本块。 - 如果这个块的长度大于
chunk_size,则不能接受它。
- 递归降级:对于所有大于
chunk_size的“超大块”,放弃使用当前分隔符,改用下一个优先级更低的分隔符(例如换行符\n)来对这个“超大块”再次进行分割。 - 重复:重复第 3 步和第 4 步,直到所有块都小于等于
chunk_size。 - 最终手段:如果尝试了所有分隔符,仍然有块大于
chunk_size,那么它会在最后一级分隔符(通常是空字符串"",即按字符切分)上,强制将文本按符合chunk_size的长度进行硬截断。
以上步骤理解即可,在我们的langchain中,已经提供好了实现,我们只需要使用就可以了。
代码参考如下:
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 创建递归切分器
recursive_splitter = RecursiveCharacterTextSplitter(
    chunk_size=200,
    chunk_overlap=40,
    separators=["\n\n", "\n", "。"]  # 优先级从高到低
)

# 切分文档
chunks = recursive_splitter.split_text(doc)

print(f"切分为 {len(chunks)} 个块:\n")
for i, chunk in enumerate(chunks):
    print(f"--- Chunk {i+1} ({len(chunk)}字符) ---")
    print(chunk)
2.2.4.结构感知切分
所谓结构感知切分,就是利用文档元数据识别文档本身的逻辑区块进行切分,例如:
- markdown中的多级标题
- JSON结构中的字段
- html中的标签
都是一些带有结构的文本数据。
LangChain都提供了对应不同文档类型的结构感知切分器,例如:
- MarkdownHeaderTextSplitter
- RecursiveJsonSplitter
- HTMLHeaderTextSplitter
- RecursiveCharacterTextSplitter.from_language()
此处,我们以最常用的markdown为例来演示。
# 结构感知切分
from langchain_text_splitters import  MarkdownHeaderTextSplitter

# 0.准备文本内容
with open("./resources/评估.md", "r", encoding="utf-8") as f:
    md_content = f.read()

# 1.准备切分器
split_on = [
    ("#", "一级标题"),
    ("##", "二级标题"),
    ("###", "三级标题"),
]
splitter = MarkdownHeaderTextSplitter(
    headers_to_split_on=split_on,
    strip_headers=False # 推荐使用False,从正文中增加标题
)

# 2.执行切分,需要特殊记忆的一点:只有一个split_text方法,返回的是list[Document]
chunks = splitter.split_text(md_content)

for index,chunk in  enumerate(chunks):
    print(
        f"""
        第{index+1}个文档
        元数据:{chunk.metadata}
        文档内容:{chunk.page_content}
        +++++++++++++++++++++++++++++++
        """)
请注意
MarkdownHeaderTextSplitter并未实现TextSpliter接口,它与前面的切分器不一样,只有一个split_text方法。
split_text方法只接收字符串,返回值一定是list[Document]
2.2.5.总结
其实,没有绝对正确的文档切分方式,一定要根据具体文档来具体判断。
比如,采用了MinerU这样的文本加载器,由于其输出的格式通常是Markdown,有严谨的文档结构,那我的建议切分方式是:
- 优先采用Markdown的文档结构感知切分,不仅语义完整度高,而且还能记住自己所处的章节;
- 当基于文档结构切分的块太大时,可以对超过目标长度的块采用递归字符切分,但要保留header到每一个分块,这样可以尽可能保证语义完整。
也就是说,一定要结合实际情况,把多种切分器混合使用。
2.3.向量化
文档切分成块后,下一步就是把文本向量化了。向量化是将文本转换为高维向量的过程。在这儿,不能再使用文本生成模型,而是要使用一种专业的文本向量(嵌入)模型。经过向量化之后,语义越相似的文本在向量空间中的距离越近,这是语义检索的基础。目前比较常见的小规模、开源文本向量模型有如下几种,常用的有两种:
- Qwen3-Embedding-0.6B
- BGE-M3
我们学习阶段使用Qwen3-Embedding-0.6B来进行文本的向量化。其中的开源模型我们可以本地私有化部署,也可以使用模型平台提供的服务,LangChain支持多种Embedding模型平台,可以自由选择,如下。
- 本地私有化部署平台
HuggingFaceEmbeddings,境外模型平台,联网麻烦,不推荐OllamaEmbeddings,推荐
- 在线模型服务平台
OpenAIEmbeddings,OpenAI(境外)提供,联网麻烦,不推荐DashScopeEmbeddings,阿里云百炼提供,推荐
更多LangChain支持的向量模型参考官方文档:Embedding model integrations - Docs by LangChain
2.3.1.Ollama Embeddings
Ollama只是模型部署软件,关键还是你基于ollama部署的模型是什么。比如,我们采用阿里提供的**qwen3-embedding:0.6b**模型,它在小模型中算是效果比较好的一个,不管是Huggingface还是Ollama都支持下载和部署这个模型,我们使用Ollama进行私有化部署。
# 运行ollama
ollama run qwen3-embedding:0.6b
安装依赖:
uv add langchain-ollama然后,可以按照如下步骤,执行文本向量化操作。
- 准备文本向量模型,关键参数
model:指定模型dimensions:指定向量维度
- 执行文本向量化操作
embed_query():将单条文本转换为单个高维向量embed_documents():将文本列表转换为高维向量列表
from langchain_ollama import OllamaEmbeddings

# 创建Embedding模型
ollama_embeddings = OllamaEmbeddings(
    model="qwen3-embedding:0.6b",  # 性价比高的模型
    dimensions=1024,  # 可选:减少维度以节省存储
    base_url="http://localhost:11434"
)

# 向量化单条文本
text = "我爱上班"
vector = ollama_embeddings.embed_query(text)


# 批量向量化
texts = ["我要躺平", "我爱工作", "拒绝加班"]
vectors = ollama_embeddings.embed_documents(texts)
print(f"\n批量向量化: {len(vectors)} 条, 维度: {len(vectors[0])}")
现在,基于余弦相似度算法,我们比较一下向量的相似度,看一看语义相似的文本,经过向量化之后,是否真的相似度更高。
其实,向量的相似度计算,不用我们手搓算法,向量数据库已经集成了相关算法,只不过还没有学习,在这儿使用AI为大家生成了基于余弦相似度的向量相似度计算方法,大家直接复制使用即可,不必深究。
print('==============衡量相似度===============')
import numpy as np


def cosine_similarity(vec1, vec2):
    """余弦相似度函数"""
    dot = np.dot(vec1, vec2)
    return dot / (np.linalg.norm(vec1) * np.linalg.norm(vec2))

# 比较向量相似度
for i, v in enumerate(vectors):
    similarity = cosine_similarity(vector, v)
    print(f"{texts[i]}:", similarity)
输出的结果如下:
Cosine Similarity: 0.40952704102474247
Cosine Similarity: 0.8738909040875059
Cosine Similarity: 0.42264466004701556
效果不错,“我爱工作”与“我要上班”的相似度值是0.8738909040875059,相似度最高,也就验证了语义越相近的文本,生成的向量的相似度也就越高。
2.3.2.阿里云Embedding
阿里云百炼平台也提供了很多文本向量化模型,比如:text-embedding-v3、text-embedding-v4模型。只要注册并配置了阿里云保留的API_KEY,就都能使用。LangChain的社区(langchain-community)提供了对阿里云模型的支持,使用需要引入下面的依赖。
uv add dashscope代码示例如下:
from langchain_community.embeddings import DashScopeEmbeddings
from dotenv import load_dotenv

load_dotenv()

# 初始化DashScopeEmbeddings,只需要指定模型名,会自动取.env读取DASHSCOPE_API_KEY
embeddings = DashScopeEmbeddings(
    model="text-embedding-v4"
    # 如果.env文件没有配置的话,这里需要手动添加api_key,base_url系统会自动推导
    # 另外,在阿里百炼平台的向量化的时候,单次只能处理20条数据,谨记!!!!
    # 另外,使用阿里百炼向量化的时候,不需要设置向量的维度
)

# 向量化单条文本
text = "我爱上班"
# 向量化后返回的是 list[float]
vector = embeddings.embed_query(text)

print(f"文本: {text}")
print(f"向量维度: {len(vector)}")
print(f"向量前5维: {vector[:5]}")


# 批量向量化
texts = ["我要躺平", "我爱工作", "拒绝加班"]
# 批量向量化,可以理解成处理很多个知识片段,返回 list[list[float]]
vectors = embeddings.embed_documents(texts)

print(f"\n批量向量化: {len(vectors)} 条, 维度: {len(vectors[0])}")
2.4.向量库
向量库用于存储和检索向量化后的文档数据库,LangChain支持多种向量库:
| 向量库 | 特点 | 适用场景 |
|---|---|---|
InMemoryVectorStore | 内存存储,零配置 | 测试学习 |
Chroma | 轻量级,支持持久化 | 中小规模 |
FAISS | 高性能,支持GPU | 大规模检索 |
Milvus | 高性能,支持GPU | 大规模检索 |
更多支持的向量库参考LangChain官方文档:Vector store integrations - Docs by LangChain
LangChain提供了统一的VectorStore接口,那就可以用统一的方式调用任意向量库,核心方法如下:
add_documents: 添加文档到向量库delete: 根据id删除某个文档similarity_search: 基于相似度检索与用户问题有关的文档
有了向量数据库,其实文本向量化不用自己做了,只要提供好向量模型即可,也就是说,LangChain的**VectorStore把向量数据库与EmbeddingModel**合并在一起了:
- 存储文档时,
VectorStore会自动把文档转向量,写入向量数据库 - 检索文档时,
VectorStore会自动把用户问题转向量,再去向量数据库搜索
接下来,我们以InMemoryVectorStore为例讲解VectorStore的用法。
2.4.1准备文档片段
我们先准备好要存入向量库的文档片段,可以基于结构感知切分器将文本切分成知识片段。
from langchain_text_splitters import MarkdownHeaderTextSplitter

# =============1.准备文档================
with open('./resources/评估.md', 'r', encoding='utf-8') as f:
    doc = f.read()

# =============2.切分文档================
# 切分依据,这里是按照三级标题
headers_to_split_on = [
    ("#", "h1"),
    ("##", "h2"),
    ("###", "h3"),
]

# 创建切分器
markdown_splitter = MarkdownHeaderTextSplitter(
    headers_to_split_on,
    strip_headers=False # 在正文中是否去除标题,False,不去除
)

# 切分文档, 返回的是 list[Document]
docs = markdown_splitter.split_text(doc)

for i, doc in enumerate(docs, start=1):
    doc.id = f'doc_{i}'
2.4.2.初始化VectorStore
InMemoryVectorStore是LangChain提供的用于测试的轻量级向量库,基于内存实现,使用非常简单,只需要两步:
- 初始化向量模型
- 初始化
InMemoryVectorStore,传入向量模型
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_ollama import OllamaEmbeddings

# 1.初始化向量模型
ollama_embeddings = OllamaEmbeddings(
    model="qwen3-embedding:0.6b",  # 性价比高的模型
    dimensions=1024,  # 可选:减少维度以节省存储
    base_url="http://localhost:11434"
)

# 2.初始化向量数据库
vector_store = InMemoryVectorStore(embedding=ollama_embeddings)
2.4.3.添加/删除文档
添加和删除方法,如下:
add_documents:接收list[Document],可以批量添加文档
# 给读取的文档增加id属性,如果我们不手动增加id属性的话,那么系统会自动帮我们进行处理,只是id不由我们可控而已。
for index, doc in enumerate(docs, start=1):
    doc.id = f'doc_{index}'
# 保存文档到向量数据库
# 此处特别注意:在阿里百炼平台单次新增向量最多20条,因此每次切分20个
docs = [docs[i:i + 20] for i in range(0, len(docs), 20)]
ids = vector_store.add_documents(docs)

print(ids)delete:接收list[str],也就是id集合,可以根据id批量删除文档
# 删除旧文档,这里的删除id就是根据上面新增的时候创建的id
vector_store.delete(["doc_1", "doc_2"])
2.4.4.检索文档
VectorStore提供了多个检索文档的方法,例如:
search: 通用搜索方法,支持最多样化的参数similarity_search: 基于相似度的搜索similarity_search_with_score: 基于相似度搜索,并且会返回相似度得分
大多数情况下我们都希望使用相似度搜索,也就是**similarity_search,而且similarity_search_with_scores与similarity_search**的参数基本一致。
下面我们先通过**similarity_search**方法实现文档相似度检索,其核心参数为:
query: 查询条件(用户的问题)k: 要返回的文档最大数量(默认值:4)score_threshold: 相似度打分的最小阈值,低于这个分值的文档会被丢弃filter: 按文档元数据(metadata)筛选
2.4.4.1.相似度检索
similarity_search方法,只返回文档,没有得分,返回值类型是list[Document]。
# 用户问题
query = "论语中教育的目的是什么"

# 相似度检索,返回值是list[Document]
results = vector_store.similarity_search(
    query=query,
    k = 5
)

# 打印结果
for doc in results:
    print(doc.model_dump_json(indent=2))
2.4.4.2.带相似度得分的检索
如果希望在返回结果中带上得分,就要用到**similarity_search_with_score**方法,需要注意,现在多了得分,最终的返回值类型不同。
similarity_search的返回值是list[Document]similarity_search_with_score的返回值是list[tuple[Document, float]]
# 相似度搜索并返回分数,结果是list[tuple[Document, float]]
results = vector_store.similarity_search_with_score(
    query,
    k = 5,
)

# 遍历结果,
for doc, score in results:
    print(f"==========score: {score}=============")
    print(doc.model_dump_json(indent=2))
结果中不仅有文档,还有分数。
2.5.总结
知识库构建核心组件,如下。
| 组件 | 作用 | 常用选择 |
|---|---|---|
| Document Loader | 加载原始文档 | MinerU, Docling |
| Text Splitter | 切分文档为chunk | MarkdownHeaderTextSplitter****RecursiveCharacterTextSplitter |
| Embeddings | 文本转向量 | OllamaEmbeddingsDashScopeEmbeddings |
| Vector Store | 存储和检索向量 | InMemory(开发), Chroma(中小), Milvus(大规模) |
一些关键参数建议。
- chunk_size: 分块大小,建议 200~1000,取决于文档类型和模型上下文长度
- chunk_overlap: 滑动窗口大小,建议 chunk_size 的 10%~20%
- k (检索数量): 检索最优文本块数量,建议 3~10,太少可能遗漏,太多可能引入噪声
3.RAG知识检索
3.1.RAG Agent架构
之前我们说过,RAG检索的基本流程是这样的:
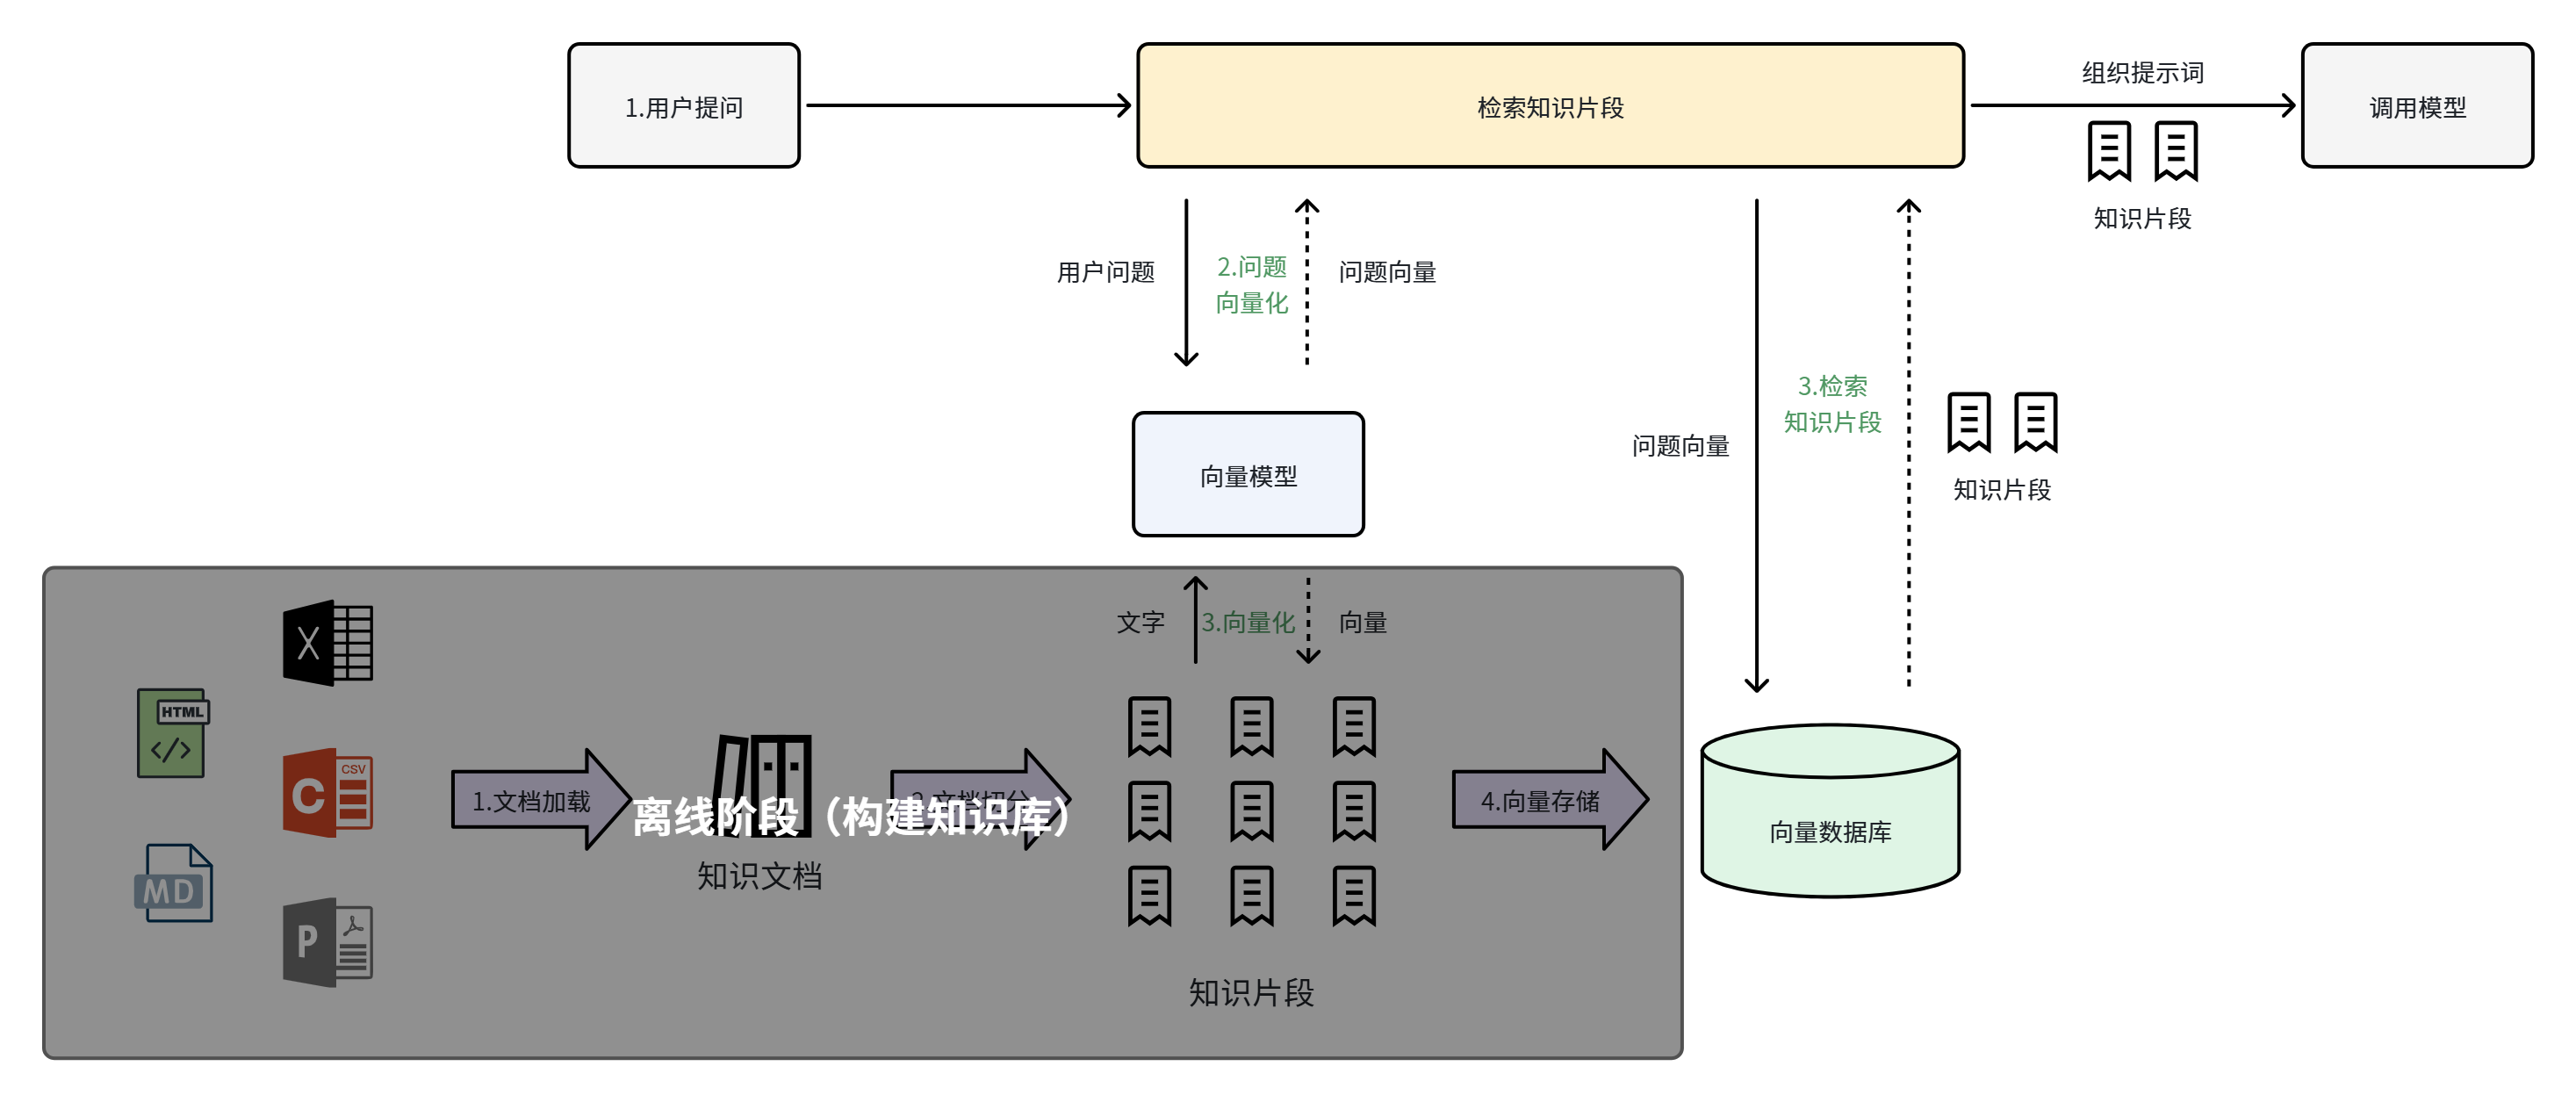
简化一下,就是这样:
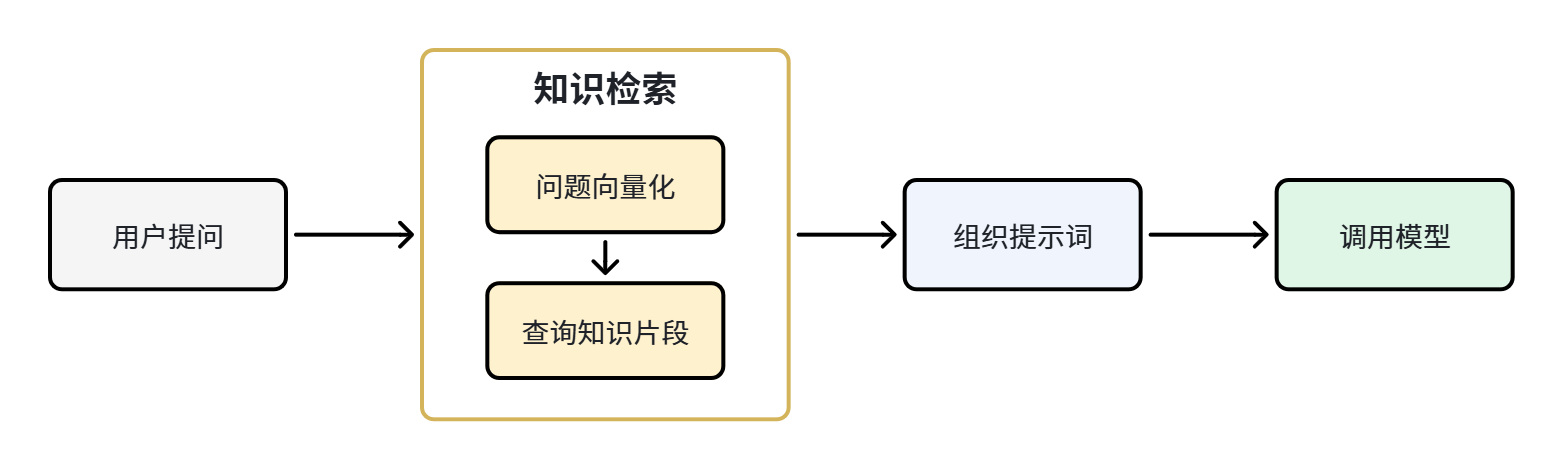
不难发现,RAG对话就是在每次调用模型前多了知识检索的步骤。
示例代码如下:
# 在线阶段
from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
load_dotenv()

# 1.用户提问
query = "论语中教育的目的"

# 2.根据问题检索知识片段
documents = vector_store.similarity_search(query)

# 3.把知识片段与问题拼接,形成提示词
# 3.1.获取知识片段上下文
context = "\n".join([doc.page_content for doc in documents])
# 3.2.拼接提示词
prompt = f"""
你是一个教资考试专家,你需要根据提供的上下文回答用户的问题,不能自己编造答案。答案要简短,直接引用原文。
context: ```{context}```
query: ```{query}```
"""

# 4.调用模型,生成答案
model = init_chat_model(
    "deepseek-v4-flash",
    extra_body = {"thinking": {"type": "disabled"}}
)

response = model.invoke(prompt)
print(response.text)
不过,在实际开发中并不是每次回答用户问题都需要知识检索,用户打招呼、询问简单问题,都可以由模型直接回答。所以,RAG系统在设计时就有三种常见的架构方式。
| 架构 | 介绍 | 可控性 | 拓展性 | 延迟 | 场景 |
|---|---|---|---|---|---|
| 2-Step RAG | 每次调用模型前都做知识检索,流程简单、可控 | ✅ High | ❌ Low | ⚡ Fast | FAQs, 文档问答机器人 |
| Agentic RAG | 由LLM来思考何时进行知识检索 | ❌ Low | ✅ High | ⏳ Variable | 绑定了很多工具的研究助手 |
| Hybrid | 结合两种方式的特点,并加入答案验证环节 | ⚖️ Medium | ⚖️ Medium | ⏳ Variable | 对回答质量要求非常高的特殊领域 |
接下来我们重点学习前两种架构。
3.2.2-Step RAG(了解)
2-Step架构非常简单,就是严格遵循RAG流程:
把RAG的流程固化为两步:
- Retrieve:检索知识库,返回知识片段
- Generate:增强生成,基于知识片段增强Prompt和用户问题,调用模型生成答案
简单来说:就是每次发送请求给LLM之前,都修改提示词,拼接检索到的知识片段。
示例代码:
from langchain.chat_models import init_chat_model
from app.core.config import settings

# 1.初始化模型
model = init_chat_model(
    "deepseek-v4-flash",
    api_key=settings.llm.api_key,
    extra_body={'thinking': {'type': 'disabled'}}
)

# 2.定义RAG函数
def rag_chat(user_input: str):
    # 1.拿到用户问题
    print("================User Message================")
    print(user_input, "\n")

    # 2.检索知识片段, lisi[Document]
    docs = vector_store.similarity_search(user_input, k=2)
    context = "\n\n".join(doc.page_content for doc in docs)
    print('=============== Context ====================')
    print(context, "\n")

    # 3.拼接新提示词
    prompt = f'''
    你是一个教资考试专家,你根据文档回答用户问题,文档中没有的不要编造,直接说不知道。
    回答直接引用文档中原文,不要自己发挥!
    context: {context}
    query: {user_input}
    '''

    # 4.调用模型
    result = model.invoke(prompt)
    print("=================AI Message================")
    print(result.content)

# 测试
rag_chat("论语中教育的目的是什么?")
即使我们只是发送一个简单问候语:“你好”,RAG完整流程还是会执行,检索了大量文档回来,这完全是浪费时间和资源。
3.3.Agentic RAG
Agent自主决定何时检索、检索什么、用不用其他工具。实现方式就是将检索器包装为Tool,Agent可以自主判合适调用工具来获取文档,甚至是多次检索,多轮迭代。
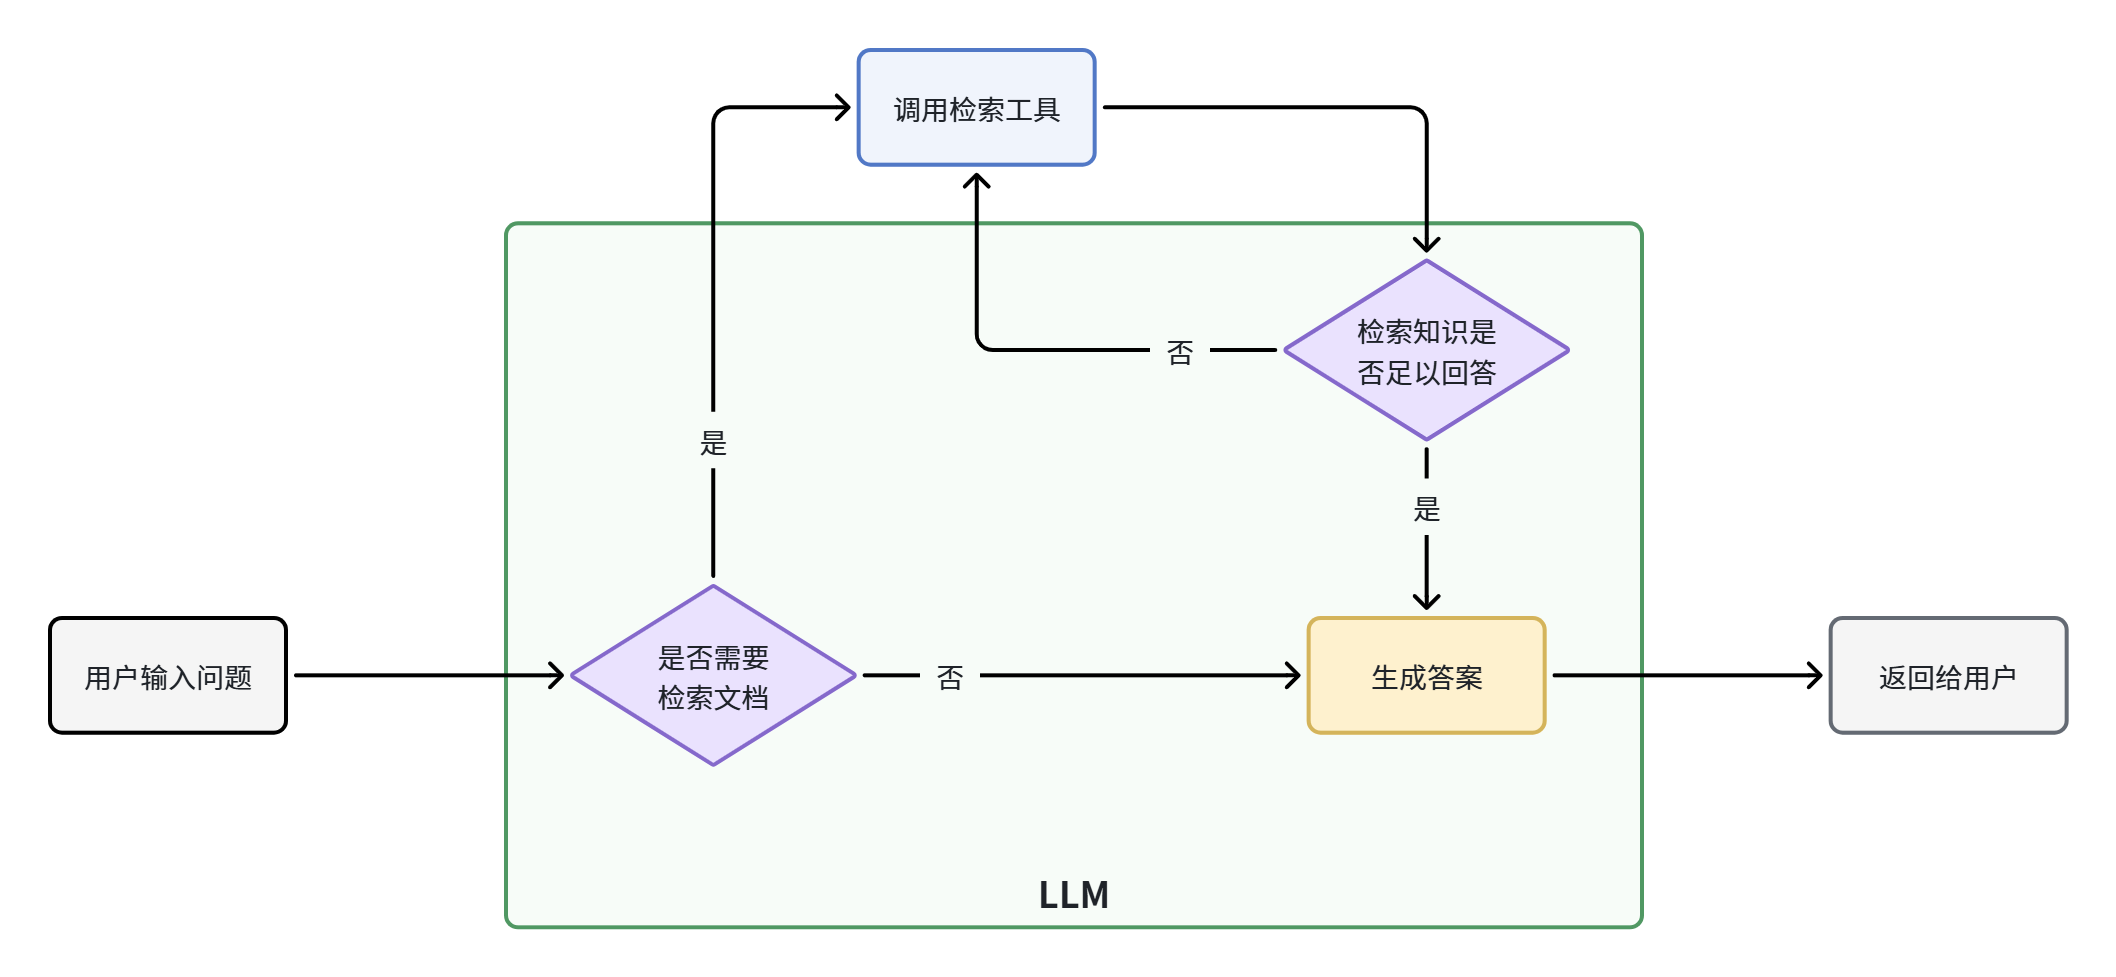
适用: 研究助手、复杂多步问答 —— 需要灵活组合多种能力的场景。
优缺点如下:
| ✅ 好处 | ⚠️ 缺点 |
|---|---|
| 只在需要时搜索—LLM可以处理问候、跟进和简单查询,而不会触发不必要的搜索。 | 两次LLM调用——在执行搜索时,需要一个调用生成查询,另一个调用生成最终响应。 |
| 上下文搜索查询 -通过将检索作为“查询”的工具,LLM可以根据会话上下文的自定义查询。 | 可能失控 - LLM可能在实际需要时跳过搜索,或者在不必要时发出额外的搜索。 |
| 允许多次搜索 - LLM可以执行多个搜索来寻找答案。 |
示例代码:
from langchain_core.tools import tool


# 定义知识库检索的工具
@tool
def retrieval_doc(query: str) -> str:
    """
    根据问题检索知识库,返回知识库文档
    :param query: 用户问题
    :return: 知识库相关性文档
    """
    docs = vector_store.similarity_search(
        query=query,
        k=5
    )
    # 提取文档内容拼接字符串
    return '\n\n'.join([doc.page_content for doc in docs])


# 初始化模型
llm = init_chat_model(
    model='deepseek-v4-flash',
    extra_body={"thinking": {'type': 'disabled'}}
)

# 创建智能体对象
agent = create_agent(
    model=llm,
    tools=[retrieval_doc],
    system_prompt='你是一个教资考试专家,你需要根据提供的上下文回答用户的问题,不能自己编造答案。答案要简短,直接引用原文。'
)

# 调用智能体
response = agent.invoke({
    'messages': [HumanMessage(content='论语中教育的目的是什么!')]
})

# 获取模型的返回结果
for message in response['messages']:
    message.pretty_print()
这样Agentic RAG可以自主思考,只在必要的时候调用RAG。