
E-R图
E-R图也称实体-联系图(Entity Relationship Diagram),提供了表示实体类型、属性和联系的方法,用来描述现实世界的概念模型。
举个栗子:
E-R举例
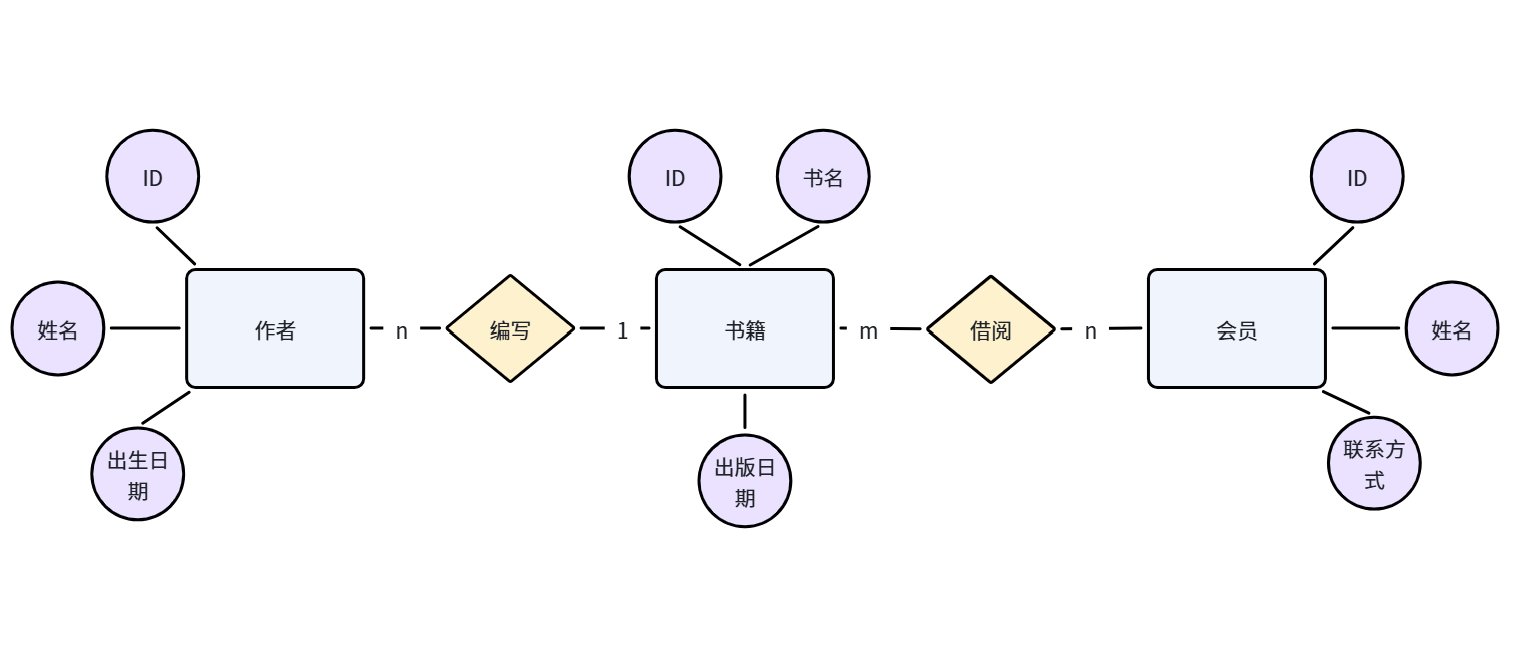
假设我们要设计一个简单的图书馆数据库系统。我们可以使用E-R图来描述这个系统的数据模型
我们可能会有以下实体(Entities):
- 书籍(Book)
- 作者(Author)
- 图书馆成员(Library Member)
然后,我们可以描述它们之间的关系(Relationships):
- 一本书可以由一个或多个作者编写,这是一个“一对多”的关系。
- 图书馆成员可以借阅多本书,而每本书也可以被多个图书馆成员借阅,这是一个“多对多”的关系。
最后,我们可以添加一些属性(Attributes):
- 书籍实体可能包括书名、ISBN号、出版日期等属性。
- 作者实体可能包括姓名、国籍、出生日期等属性。
- 图书馆成员实体可能包括会员号、姓名、联系信息等属性。
通过E-R图,我们可以清晰地展示这些实体之间的关系和它们的属性,从而更好地理解图书馆数据库系统的数据模型。
上面例子中的E-R图如下:
设计表的注意事项
命名需要见名知意,表名和字段必须小写,多个单独用英文下划线连接
数据类型
- 可靠性:考虑字段存储的内容长度,尽可能的合适
- 存储空间:在考虑可靠性的前提下,再次考虑存储空间
基础字段
- 主键ID
- 自增(少量数据)
- UUID(字符串,影响效率及存储空间)
- 雪花算法(推荐,数字)
- 创建时间
- 修改时间
- 创建人
- 修改人
- 备注
- 主键ID
业务字段
- 要结合业务的情况,根据业务实体属性来设计
- 再去设计冗余字段(为了提升性能,减少多表查询)
关联字段
- 外键ID,要使用逻辑外键,不要使用物理外键
垂直分割
下面我们来看一张用户信息的数据表:
CREATE TABLE `user` (
  `id` BIGINT NOT NULL COMMENT '用户主键',
  `username` VARCHAR(50) NOT NULL COMMENT '登录账号',
  `nickname` VARCHAR(50) NOT NULL COMMENT '昵称',
  `password_hash` VARCHAR(128) NOT NULL COMMENT '密码密文',
  `phone` VARCHAR(20) DEFAULT NULL COMMENT '手机号',
  `avatar` VARCHAR(255) DEFAULT NULL COMMENT '头像地址',
  `email` VARCHAR(100) DEFAULT NULL COMMENT '邮箱',
  `user_status` TINYINT NOT NULL DEFAULT 1 COMMENT '状态:0禁用 1正常',
  `vip_level` TINYINT NOT NULL DEFAULT 0 COMMENT '会员等级',
  `register_time` DATETIME NOT NULL COMMENT '注册时间',
  `last_login_time` DATETIME DEFAULT NULL COMMENT '最后登录时间',
  `update_time` DATETIME NOT NULL ON UPDATE CURRENT_TIMESTAMP COMMENT '更新时间',
  `real_name` VARCHAR(30) DEFAULT NULL COMMENT '真实姓名',
  `id_card_no` VARCHAR(20) DEFAULT NULL COMMENT '身份证号(加密存储)',
  `id_card_address` VARCHAR(255) DEFAULT NULL COMMENT '身份证住址',
  `id_card_nation` VARCHAR(20) DEFAULT NULL COMMENT '民族',
  `id_card_birth` DATE DEFAULT NULL COMMENT '出生日期',
  `id_card_gender` TINYINT DEFAULT NULL COMMENT '性别 1男 2女',
  `id_card_authority` VARCHAR(100) DEFAULT NULL COMMENT '签发机关',
  `id_card_valid_start` DATE DEFAULT NULL COMMENT '证件有效期开始',
  `id_card_valid_end` DATE DEFAULT NULL COMMENT '证件有效期结束',
  `id_card_front_img` VARCHAR(255) DEFAULT NULL COMMENT '身份证正面照片地址',
  `id_card_back_img` VARCHAR(255) DEFAULT NULL COMMENT '身份证反面照片地址',
  `audit_status` TINYINT DEFAULT 0 COMMENT '实名审核状态:0未提交 1审核中 2通过 3驳回',
  `audit_msg` VARCHAR(200) DEFAULT NULL COMMENT '审核备注',
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_username` (`username`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='用户总表(未垂直拆分,共25字段)';
在这张表中,我们可以发现表中的字段非常多,而且很多字段我们并不会频繁使用。字段太多还会带来下面的这些问题:
- 性能下降,字段越多,数据库在执行查询时需要处理的数据量就越大,插入和更新尤为明显
- 维护困难:字段过多会使得表结构复杂,导致难以理解和维护,同时修改表结构也会变得更加复杂和耗时。
- 存储空间增加:每个额外的字段,即使大多数情况下为空或数据很少,也会占用额外存储空间,并可能导致数据库备份和恢复操作耗时增加。
- 可扩展性差:当表结构变得过于复杂时,添加新功能或进行其他类型的扩展可能会变得更加困难。
因为,为了解决上面的这些问题,我们可以考虑下面的这些策略:
- :将表垂直分割成多个较小的表,每个表包含相关的字段集。
- 归档旧数据:将不经常访问的旧数据归档到单独的表中或数据库中。
- 优化数据类型:确保使用适当的数据类型来存储数据,以减少存储空间的浪费并提高性能。
那么什么是垂直分割呢?
垂直分割表是数据库管理中常用的一种优化技术,它通过将一个大表中的列分割成多个小表,每个小表包含原始表的一部分列,以达到优化数据存储和访问效率的目的。主表:高频查询、短小字段(如name,status,create_time),扩展表:低频、大字段(如content,remark,file_data)。
垂直分割的优缺点
优点
- 提高查询性能:通过减少表的宽度,可以加快查询速度,特别是在涉及大量列的表中。当查询只需要访问部分列时,数据库系统只需扫描包含这些列的小表,减少了不必要的数据扫描量。
- 减少I/O操作:在读取数据时,数据库系统可以只读取需要的列,而无需扫描整个表,从而减少了I/O操作的次数和数据传输量。
- 后续需要新增证件字段、修改实名规则,只修改
user_identity;不用对大的 user_main 表执行 ALTER,避免锁表影响登录、用户查询等核心业务。
缺点
- 增加复杂性:垂直分割表会增加数据库结构的复杂性,需要更多的管理和维护工作。例如,需要修改应用程序中的查询和更新操作,以适应新的表结构。
- 事务处理复杂:垂直分割表后,事务的处理可能会变得更加复杂。因为事务可能需要跨越多个子表,这增加了事务管理的难度和开销。
- 表连接操作增加:由于数据被分散到多个子表中,因此在查询时可能需要更多的表连接操作,这可能会增加CPU的开销和查询的响应时间。
经过垂直分割的处理之后,上面案例中的user表可以拆分为下面的两个表:
表 1:user_main 用户主表(高频基础字段,12 个):
CREATE TABLE `user_main` (
  `id` BIGINT NOT NULL COMMENT '用户主键,和user_identity.id一一对应',
  `username` VARCHAR(50) NOT NULL COMMENT '登录账号',
  `nickname` VARCHAR(50) NOT NULL COMMENT '昵称',
  `password_hash` VARCHAR(128) NOT NULL COMMENT '密码密文',
  `phone` VARCHAR(20) DEFAULT NULL COMMENT '手机号',
  `avatar` VARCHAR(255) DEFAULT NULL COMMENT '头像地址',
  `email` VARCHAR(100) DEFAULT NULL COMMENT '邮箱',
  `user_status` TINYINT NOT NULL DEFAULT 1 COMMENT '状态:0禁用 1正常',
  `vip_level` TINYINT NOT NULL DEFAULT 0 COMMENT '会员等级',
  `register_time` DATETIME NOT NULL COMMENT '注册时间',
  `last_login_time` DATETIME DEFAULT NULL COMMENT '最后登录时间',
  `update_time` DATETIME NOT NULL ON UPDATE CURRENT_TIMESTAMP COMMENT '更新时间',
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_username` (`username`),
  UNIQUE KEY `uk_phone` (`phone`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='用户主表|高频基础信息';
表 2:user_identity 用户实名扩展表(低频敏感字段,13 个):
CREATE TABLE `user_identity` (
  `id` BIGINT NOT NULL COMMENT '用户ID,关联user_main主键',
  `real_name` VARCHAR(30) NOT NULL COMMENT '真实姓名',
  `id_card_no` VARCHAR(20) NOT NULL COMMENT '身份证号(加密存储)',
  `id_card_address` VARCHAR(255) DEFAULT NULL COMMENT '身份证住址',
  `id_card_nation` VARCHAR(20) DEFAULT NULL COMMENT '民族',
  `id_card_birth` DATE DEFAULT NULL COMMENT '出生日期',
  `id_card_gender` TINYINT DEFAULT NULL COMMENT '性别 1男 2女',
  `id_card_authority` VARCHAR(100) DEFAULT NULL COMMENT '签发机关',
  `id_card_valid_start` DATE DEFAULT NULL COMMENT '证件有效期开始',
  `id_card_valid_end` DATE DEFAULT NULL COMMENT '证件有效期结束',
  `id_card_front_img` VARCHAR(255) DEFAULT NULL COMMENT '身份证正面照片地址',
  `id_card_back_img` VARCHAR(255) DEFAULT NULL COMMENT '身份证反面照片地址',
  `audit_status` TINYINT NOT NULL DEFAULT 0 COMMENT '实名审核状态',
  `audit_msg` VARCHAR(200) DEFAULT NULL COMMENT '审核备注',
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_idcard` (`id_card_no`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='用户实名身份证信息表|低频敏感数据';
查询示例如下:
-- 普通业务:只查主表(绝大多数场景)
SELECT id,username,nickname,phone,avatar,user_status,vip_level
FROM user_main WHERE id = 10001;

-- 需要实名信息:关联查询
SELECT m.*,i.real_name,i.id_card_no,i.audit_status
FROM user_main m
LEFT JOIN user_identity i ON m.id = i.id
WHERE m.id = 10001;
垂直分割使用注意事项
垂直分表:不要过度拆分,join 太多反而性能下降
当一张表字段很多,并且字段访问频率差异明显、存在敏感字段或者大字段,适合垂直拆分;如果每次查询几乎都要用到所有字段,就不要拆。
接口四要素
一个接口包含了四个基本要素,分别是:请求路径、请求方式、接口入参、接口出参(参数被称为报文)
- 请求路径 命名:以模块名称进行区分(英文)【常用编程风格:RESTFUL 一个路径代表一个资源 /user/1】
- 请求方式(需要符合restFul风格)
- 查询 GET
- 新增 POST
- 修改 PUT
- 删除 DELETE
- 接口入参
- 路径参数
- 问号传参---->后端形参接收
- path传参---->后端PathVariable注解接收
- 请求体参数
- 前端:json对象
- 后端:对象接收,DTO
- 路径参数
- 接口出参
- 统一格式
{code:200,msg:"成功",data:{}} - 数据封装,一般为VO
- 敏感数据过滤
- 整合数据
- 统一格式